Crawled Currently Not Indexed là gì? Nguyên nhân và cách xử lý đúng
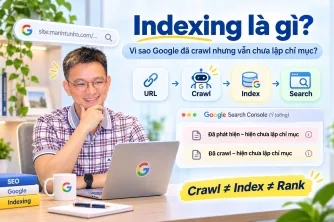
Crawled - currently not indexed là trạng thái trong Google Search Console cho biết Google đã crawl URL nhưng hiện chưa đưa URL đó vào Google Index.
Điểm quan trọng nhất là Google đã thực sự truy cập trang.
Điều này khác hoàn toàn với Discovered - currently not indexed khi Google mới biết URL tồn tại nhưng chưa crawl.
Có thể hiểu ngắn gọn:
Discovered → Google biết URL nhưng chưa đọc.
Crawled → Google đã đọc URL nhưng hiện chưa index.
Vì vậy khi một trang nằm trong trạng thái Crawled currently not indexed việc tiếp tục tập trung vào chuyện “làm sao để Googlebot vào trang” có thể không còn là câu hỏi chính.
Googlebot đã vào rồi.
Câu hỏi cần đặt tiếp theo là vì sao URL này chưa được Google lựa chọn để nằm trong index.
Google chính thức cho biết một URL ở trạng thái này có thể hoặc không được index trong tương lai và không cần gửi lại URL chỉ để yêu cầu crawl thêm lần nữa.
Điều này cũng có nghĩa việc liên tục bấm Request Indexing không phải giải pháp mặc định.
Trước khi sửa nội dung cần kiểm tra xem URL có thực sự là một trang mà website muốn index hay không.
Một số URL không được index là hoàn toàn bình thường.
Ví dụ URL duplicate trang chuyển hướng URL có canonical sang trang khác hoặc những trang không có giá trị độc lập không nhất thiết phải xuất hiện riêng trong Google Index.
Google cũng không yêu cầu website phải đạt tỷ lệ 100 phần trăm URL được index.
Mục tiêu hợp lý hơn là những canonical URL quan trọng phải có khả năng được index.
Đối với một URL quan trọng nên bắt đầu bằng URL Inspection.
Kiểm tra URL trả về HTTP 200 hay không indexing có được phép hay không canonical do website khai báo là gì và Google đang hiểu URL như thế nào.
Cũng cần kiểm tra phiên bản Google đã crawl thay vì chỉ nhìn Live Test.
Live Test cho biết Google hiện có khả năng truy cập trang nhưng không kiểm tra đầy đủ mọi điều kiện liên quan đến indexing.
Google lưu ý rằng một số vấn đề như duplicate và canonical không được đánh giá đầy đủ trong Live Test.
Vì vậy trạng thái “URL is available to Google” trong Live Test không đồng nghĩa URL chắc chắn sẽ được index.
Canonical là một điểm cần kiểm tra rất kỹ.
Nếu trang khai báo canonical sang URL khác hoặc Google lựa chọn một URL khác làm canonical thì URL đang xem có thể không được index độc lập.
Đây không nhất thiết là lỗi nếu hai URL thực sự là các phiên bản trùng nhau.
Vấn đề chỉ xuất hiện khi URL quan trọng bị Google xem như duplicate của một trang không phù hợp.
Tiếp theo cần xem nội dung có đủ khác biệt và giá trị độc lập hay không.
Một website có thể tạo rất nhiều URL khác nhau về kỹ thuật nhưng lại chứa nội dung gần như giống nhau.
Ví dụ các trang tag category filter hoặc landing page chỉ thay đổi vài từ trong tiêu đề nhưng phần còn lại gần giống nhau.
Trong trường hợp đó việc mỗi URL đều trả 200 và có canonical tự trỏ chưa chắc đủ để khiến tất cả được index.
Điều cần xem là mỗi URL có giải quyết một search intent riêng và cung cấp nội dung đủ khác biệt hay không.
Thin content cũng đáng kiểm tra.
Một trang chỉ có tiêu đề vài dòng giới thiệu rồi danh sách một hoặc hai bài có thể chưa có nhiều giá trị độc lập so với các trang khác trong website.
Điều này đặc biệt liên quan đến hệ thống tag.
Nếu tạo hàng trăm tag nhưng mỗi tag chỉ có một bài hoặc các tag có intent gần như giống nhau thì website có thể tự tạo ra rất nhiều URL yếu.
Trong trường hợp đó giải pháp không phải viết thêm vài câu cho tất cả tag.
Cần xem lại taxonomy.
Một số tag nên được giữ và phát triển thành topic hub.
Một số tag nên merge.
Một số tag nên redirect.
Một số tag có thể phù hợp hơn với noindex nếu chúng chỉ phục vụ điều hướng và không có search intent riêng.
Internal link cũng cần được xem xét.
Một URL quan trọng nên xuất hiện tự nhiên trong cấu trúc website và được liên kết từ những trang có liên quan.
Nếu một trang chỉ tồn tại trong sitemap nhưng gần như không có internal link thì vị trí của nó trong topical architecture rất yếu.
Internal link không phải nút ép indexing nhưng giúp Google hiểu mối quan hệ chủ đề và tầm quan trọng tương đối của URL.
Sitemap cũng chỉ nên chứa những URL canonical indexable mà website thực sự muốn Google đưa vào index.
Một URL nằm trong sitemap không đồng nghĩa Google phải index nó.
Sitemap chủ yếu giúp discovery và cung cấp thêm thông tin về những URL website muốn công cụ tìm kiếm biết đến.
Đối với những website có nhiều trang tương tự nhau cần kiểm tra duplicate content.
Duplicate không chỉ có nghĩa nội dung giống 100 phần trăm.
Nhiều trang có cùng cấu trúc cùng phần lớn nội dung và chỉ khác một số từ hoặc danh sách nhỏ vẫn có thể tạo ra giá trị rất giống nhau.
Cũng nên kiểm tra nội dung được render mà Google thực sự nhìn thấy.
Nếu phần nội dung chính phụ thuộc hoàn toàn vào JavaScript lỗi hoặc tài nguyên cần thiết bị chặn thì Google có thể crawl URL nhưng không nhận được cùng nội dung như người dùng.
Đây là lúc URL Inspection và rendered HTML trở nên hữu ích.
Soft 404 hoặc những trang gần như không có nội dung cũng cần được xem xét dù HTTP status vẫn là 200.
Một trang kỹ thuật tồn tại không có nghĩa trang đó có đủ nội dung để trở thành một tài liệu tìm kiếm độc lập.
Người quản trị cũng nên nhìn vấn đề ở cấp website chứ không chỉ từng URL.
Nếu chỉ một vài trang mới nằm trong trạng thái Crawled currently not indexed thì đó có thể là một phần bình thường của quá trình indexing.
Nếu hàng trăm hoặc hàng nghìn URL nội dung chính cùng rơi vào trạng thái này thì cần xem lại chất lượng và cấu trúc của cả nhóm trang.
Trong các thảo luận gần đây trên Google Search Central Community các Product Expert thường chỉ ra rằng trạng thái này hay xuất hiện khi trang quá mỏng rất giống những trang khác hoặc không bổ sung nhiều giá trị độc đáo so với những tài liệu Google đã có.
Điều này không có nghĩa Search Console đang cung cấp một lý do chất lượng cụ thể cho từng URL.
Trạng thái chính thức chỉ nói Google đã crawl nhưng hiện chưa index.
Phần nguyên nhân vẫn cần được điều tra.
Đây là một phân biệt rất quan trọng.
Không nên nhìn thấy Crawled currently not indexed rồi kết luận ngay “Google phạt vì content kém”.
Cũng không nên nhìn thấy trạng thái này rồi cho rằng chỉ cần sửa robots.txt sitemap hoặc crawl budget.
Google đã crawl trang rồi nên cần kiểm tra đúng tầng vấn đề.
Một quy trình xử lý có thể đi theo thứ tự:
URL có thực sự cần index không → HTTP 200 và indexable không → canonical đúng không → Google có thấy đầy đủ nội dung không → trang có search intent riêng không → có trùng với URL khác không → nội dung có đủ giá trị độc lập không → internal link có rõ không → taxonomy có tạo quá nhiều URL yếu không.
Nếu phát hiện nội dung yếu thì nên cải thiện nội dung thật sự.
Không nên chỉ đổi vài câu thêm ngày cập nhật hoặc tăng số từ một cách cơ học.
Một trang dài 3000 từ nhưng lặp lại thông tin các trang khác vẫn có thể ít giá trị hơn một trang 800 từ giải quyết đúng một vấn đề rất cụ thể.
Nếu hai URL có cùng search intent thì merge thường tốt hơn việc cố viết lại hai phiên bản để giữ cả hai.
Nếu một tag không có đủ nội dung hoặc không có vai trò rõ trong topical architecture thì noindex hoặc loại bỏ cũng có thể hợp lý hơn cố ép Google index.
Sau khi thực hiện thay đổi thực sự có ý nghĩa có thể sử dụng Request Indexing cho một số URL quan trọng.
Nhưng không cần gửi yêu cầu lặp đi lặp lại.
Google vẫn tự quyết định việc index.
Đối với số lượng lớn URL nên để sitemap internal link và quá trình crawl bình thường giúp Google đánh giá lại theo thời gian.
Không nên cập nhật dateModified giả chỉ để hy vọng Google crawl lại.
dateModified nên phản ánh một thay đổi nội dung có ý nghĩa.
Tag Crawled Currently Not Indexed tổng hợp các bài viết và hướng dẫn về Google Search Console indexing canonical duplicate content thin content URL Inspection internal link taxonomy và cách xử lý những URL Google đã crawl nhưng hiện chưa được đưa vào Google Index.