
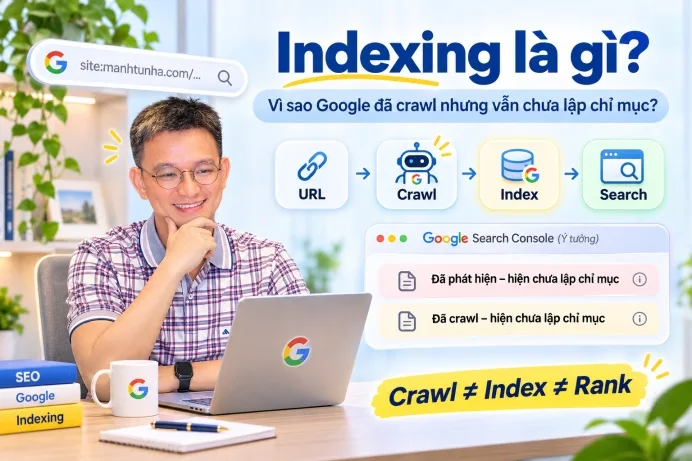
Indexing là gì? Vì sao Google đã crawl bài nhưng vẫn không lập chỉ mục?
Xem nhanh:
- Indexing là gì?
- Crawl là gì?
- Indexing khác Crawling ở điểm nào?
- Đáp ứng kỹ thuật không đồng nghĩa chắc chắn được Index
- Google Search Console nói “Not indexed” có phải website đang lỗi?
- Đừng cố làm biểu đồ Search Console xanh 100%
- Discovered - currently not indexed là gì?
- Tại sao URL bị Discovered - currently not indexed?
- Crawled - currently not indexed là gì?
- Crawled - currently not indexed không nhất thiết là lỗi Technical SEO
- Một câu hỏi khó: Google có thấy trang này đáng tồn tại trong Index không?
- Thin Content không chỉ là số chữ
- Indexing và Topical Authority có liên quan không?
- Indexing và Internal Link
- Sitemap có đảm bảo được Index không?
- Request Indexing có đảm bảo Index không?
- Request Indexing 20 lần có nhanh hơn không?
- Indexing API có dùng để submit bài blog không?
- robots.txt có ngăn Index không?
- Noindex và Canonical có nên dùng cùng lúc?
- HTTP Status cũng quyết định khả năng Index
- Indexing và JavaScript
- “Page with redirect” có cần sửa không?
- “Alternate page with proper canonical tag” có cần sửa không?
- “Duplicate, Google chose different canonical than user” thì sao?
- 404 có phải cứ thấy là phải Redirect?
- Cách Nha đọc Page Indexing Report
- Checklist xử lý một URL không được Index
- 1. URL có thực sự cần Index không?
- 2. HTTP Status
- 3. Googlebot có crawl được không?
- 4. Có noindex không?
- 5. Canonical là URL nào?
- 6. URL có trong Sitemap không?
- 7. Có Internal Link không?
- 8. Nội dung có khác các URL khác đủ nhiều không?
- 9. Search Intent có rõ không?
- 10. Nội dung có lý do tồn tại không?
- 11. Google đã crawl chưa?
- 12. Sau khi sửa mới Request Indexing
- Không phải URL nào cũng đáng cứu
- Index bloat là gì?
- Áp vào manhtunha.com thì sao?
- Google không Index một bài không có nghĩa bài dở
- Crawl Budget có phải vấn đề của mọi website?
- Indexing trong thời AI Search có thay đổi gì không?
- Điều Nha thay đổi trong cách nhìn về Indexing
- Bạn nên mang gì về sau bài này?
- Nguồn và tài liệu tham khảo
Có một trạng thái trong Google Search Console khá dễ làm người làm website sốt ruột:
Crawled - currently not indexed.
Google đã tới.
Google đã đọc.
Nhưng Google vẫn không đưa trang vào index.
Khá giống chuyện mời khách tới nhà.
Khách tới.
Uống nước.
Nhìn quanh một vòng.
Rồi về.
Không nói gì.
Nếu mới làm SEO, phản xạ rất tự nhiên là:
Request Indexing lại.
Không được?
Request lần nữa.
Vẫn chưa?
Lại submit.
Nha từng nghĩ chuyện indexing khá đơn giản như vậy.
Bây giờ Nha nhìn khác.
Bởi vấn đề không chỉ là:
Google đã biết URL chưa?
Mà còn là:
Google có thấy URL này đáng đưa vào index hay không?
Indexing là gì?
Google mô tả Search theo ba giai đoạn chính:
- Crawling – Google tìm và tải nội dung của URL.
- Indexing – Google phân tích nội dung và quyết định lưu thông tin vào chỉ mục.
- Serving – khi người dùng tìm kiếm, Google lựa chọn những trang phù hợp từ index để hiển thị.
Điểm quan trọng là:
Không phải URL nào được crawl cũng được index.
Và:
Không phải URL nào được index cũng sẽ rank cho truy vấn mình muốn.
Ba chuyện này khác nhau.
Crawl được ≠ Index được ≠ Rank đượcNha nghĩ chỉ cần nhớ công thức này đã tránh được khá nhiều hiểu lầm.
Crawl là gì?
Crawl là lúc Googlebot truy cập một URL và tải nội dung của trang.
Google có thể phát hiện URL qua:
- Internal Link;
- Backlink;
- Sitemap;
- URL đã biết từ trước;
- hoặc các nguồn khám phá khác.
Sau khi biết URL tồn tại, Google quyết định khi nào và có crawl URL đó hay không.
Google không hứa:
Cứ có trong sitemap là tôi crawl ngay.
Sitemap chỉ giúp Google biết về URL.
Nó không phải lệnh.
Indexing khác Crawling ở điểm nào?
Sau khi crawl, Google bắt đầu phân tích.
Trong giai đoạn indexing, Google có thể xem:
- text;
- title;
- ảnh;
- video;
- alt;
- structured data;
- canonical;
- ngôn ngữ;
- và nhiều tín hiệu khác.
Google cũng cố xác định:
Trang này có phải duplicate của một trang khác không?
Nếu có, Google có thể gom các trang gần giống thành một cluster rồi chọn một canonical đại diện.
Nha đã viết riêng về chuyện này trong bài Canonical URL là gì? Vì sao Google chọn URL khác?.
Sau quá trình đó, trang có thể được lưu vào Google index.
Hoặc không.
Đáp ứng kỹ thuật không đồng nghĩa chắc chắn được Index
Google hiện đưa ra ba yêu cầu kỹ thuật tối thiểu để một trang đủ điều kiện được index:
- Googlebot không bị chặn;
- server trả HTTP 200;
- trang có nội dung Google có thể index.
Nhưng ngay sau đó Google nói rất rõ:
Đáp ứng các yêu cầu này vẫn không đảm bảo trang sẽ được index.
Đây là điểm Nha thấy rất quan trọng.
Nhiều website kiểm tra:
200 OK robots.txt OK noindex không có canonical OK sitemap OKrồi kết luận:
Google phải index.
Không.
Kỹ thuật chỉ giúp trang:
đủ điều kiện.
Nó không tạo quyền bắt Google phải lưu URL.
Google Search Console nói “Not indexed” có phải website đang lỗi?
Không phải lúc nào cũng vậy.
Đây là một điểm Google hiện nhấn mạnh khá rõ trong Page Indexing Report.
Một website bình thường có thể có rất nhiều URL không được index.
Ví dụ:
- redirect URL;
- duplicate URL;
- parameter URL;
- canonical alternate;
- 404;
- URL intentionally noindex;
- các URL kỹ thuật mà mình không hề muốn xuất hiện trên Search.
Google thậm chí nói:
Không nên kỳ vọng 100% URL của website được index.
Mục tiêu đúng hơn là:
Những URL quan trọng và canonical URL mà mình muốn xuất hiện trên Search phải được index.
Khác biệt này khá lớn.
Đừng cố làm biểu đồ Search Console xanh 100%
Nha thấy đây là một KPI hơi nguy hiểm.
Ví dụ website có:
1.000 URL Indexed 800 URL Not IndexedNhìn khá đáng sợ.
Nhưng 800 URL kia có thể gồm:
- 300 parameter URL;
- 200 pagination/filter không cần index;
- 100 redirect;
- 100 duplicate;
- 100 URL cũ đã bỏ.
Nếu vậy:
Not Indexed chính xác lại là kết quả mình muốn.
Đừng sửa một trạng thái chỉ vì nó nằm trong cột màu xám.
Hãy hỏi:
URL này có đáng được index không?
Discovered - currently not indexed là gì?
Đây là một trạng thái rất phổ biến.
Nó có nghĩa:
Google biết URL tồn tại nhưng hiện chưa crawl URL đó.
Tức là:
Google biết URL ↓ chưa crawl ↓ chưa indexGoogle có thể biết URL từ sitemap hoặc Internal Link.
Nhưng Google chưa dành tài nguyên để crawl.
Tại sao URL bị Discovered - currently not indexed?
Không nên nhìn trạng thái này rồi kết luận ngay:
Trang bị lỗi.
Có nhiều khả năng.
URL còn mới
Google chưa tới lượt crawl.
Internal Link yếu
Trang nằm quá sâu hoặc gần như orphan.
Google biết URL từ sitemap nhưng không thấy website coi URL đó quan trọng.
Website sinh quá nhiều URL
Ví dụ:
- parameter;
- filter;
- pagination;
- calendar;
- search result;
- session URL.
Google phải quyết định nên crawl cái gì trước.
Server hoặc crawl capacity
Nếu server chậm, lỗi hoặc Google phát hiện việc crawl có thể gây tải lớn, Google có thể giảm tốc.
Crawl demand thấp
Không phải mọi URL đều được ưu tiên giống nhau.
Nếu trang nằm sâu, ít Internal Link, ít thay đổi và không có nhiều tín hiệu giá trị, Google có thể chưa ưu tiên crawl.
Crawled - currently not indexed là gì?
Trạng thái này khác.
Nó có nghĩa:
Google đã crawl URL nhưng hiện chưa đưa nó vào index.
Tức là:
Google biết URL ↓ đã crawl ↓ chưa indexVì vậy nếu một URL nằm ở đây, việc tiếp tục hỏi:
Làm sao để Google biết URL này tồn tại?
không còn là câu hỏi chính nữa.
Google biết rồi.
Thậm chí đã đọc rồi.
Câu hỏi nên đổi thành:
Tại sao sau khi đọc, Google vẫn chưa muốn index?
Crawled - currently not indexed không nhất thiết là lỗi Technical SEO
Đây là điều Nha muốn nhấn mạnh nhất của bài.
Một URL có thể:
- HTTP 200;
- không noindex;
- robots.txt cho crawl;
- canonical đúng;
- nằm trong sitemap;
- và vẫn không được index.
Khi đó đừng tiếp tục chỉ sửa Technical SEO.
Cần nhìn sang:
- giá trị nội dung;
- Search Intent;
- duplicate/near duplicate;
- thin content;
- mức độ nguyên bản;
- Internal Link;
- và vai trò của URL trong toàn website.
Một câu hỏi khó: Google có thấy trang này đáng tồn tại trong Index không?
Nha thích dùng câu hỏi này khi audit.
Ví dụ website có 100 tag page.
Mỗi tag chỉ có:
- một tiêu đề;
- một dòng mô tả;
- một bài viết.
Về kỹ thuật:
Hoàn hảo.
200 OK.
Canonical.
Schema.
Sitemap.
Nhưng nếu Google index đủ 100 trang đó thì người dùng nhận thêm giá trị gì?
Đó mới là câu hỏi.
Thin Content không chỉ là số chữ
Nha không xem thin content đơn giản là:
< 500 từ = thinMột trang 200 chữ có thể giải quyết rất tốt một câu hỏi.
Một trang 3.000 chữ vẫn có thể mỏng về giá trị nếu:
- toàn bộ chỉ rewrite;
- không có thông tin mới;
- không có mục đích riêng;
- và gần giống hàng chục trang khác.
Google năm 2026 tiếp tục nhấn mạnh nội dung:
- unique;
- valuable;
- non-commodity;
- people-first.
Điều đó cũng liên quan trực tiếp tới câu chuyện indexing.
Indexing và Topical Authority có liên quan không?
Có thể liên quan về mặt kiến trúc và giá trị, nhưng đừng biến thành công thức.
Trong bài Topical Authority là gì?, Nha đã nói về việc các bài nên tạo thành một thư viện kiến thức.
Một bài mới nằm trong cluster:
SEO ↓ Indexing ↓ Canonical ↓ Sitemap ↓ robots.txtcó nhiều đường để được crawler khám phá hơn một URL bị bỏ cô lập.
Nhưng:
Có Internal Link không có nghĩa Google bắt buộc index.
Nó chỉ giúp discovery và thể hiện vai trò của trang rõ hơn.
Indexing và Internal Link
Google nói phần lớn URL mới được khám phá thông qua link từ những trang đã biết.
Vì vậy một bài quan trọng nên nhận Internal Link từ:
- category;
- pillar;
- những bài liên quan;
- navigation nếu phù hợp.
Nha đã viết riêng bài Internal Link là gì?.
Nếu bài mới chỉ xuất hiện trong sitemap nhưng không URL nào trên website link tới nó, Nha sẽ xem lại.
Sitemap nói:
URL này tồn tại.
Internal Link còn nói:
URL này nằm ở đâu trong thư viện của tôi.
Sitemap có đảm bảo được Index không?
Không.
Google nói khá rõ:
Sitemap giúp Google tìm URL nhưng không đảm bảo URL sẽ được crawl hoặc index.
Sitemap cũng không làm ranking tăng chỉ vì URL được đưa vào đó.
Nha xem sitemap như:
Danh sách những URL quan trọng mà website muốn Google biết tới.
Không phải:
Danh sách URL Google bắt buộc phải index.
Request Indexing có đảm bảo Index không?
Cũng không.
Trong URL Inspection, chúng ta có:
Request IndexingNó hữu ích khi:
- bài mới quan trọng;
- bài vừa được cập nhật đáng kể;
- URL cần Google crawl lại.
Nhưng Request Indexing chủ yếu là:
Xin Google đưa URL vào hàng đợi xem xét lại.
Không phải:
Xin Google bắt buộc index URL này.
Request Indexing 20 lần có nhanh hơn không?
Không.
Nếu trang đã được crawl rồi mà vẫn:
Crawled - currently not indexedthì request đi request lại không giải quyết được nguyên nhân gốc.
Nha thích ví dụ:
Gõ cửa một lần.
Người ta đã mở.
Người ta đã xem hồ sơ.
Người ta chưa nhận.
Gõ cửa thêm 30 lần không làm hồ sơ tốt hơn.
Indexing API có dùng để submit bài blog không?
Đây cũng là hiểu lầm khá phổ biến.
Google Indexing API không phải API chung để submit mọi URL.
Nó chỉ được Google hỗ trợ cho một số loại nội dung cụ thể như:
- JobPosting;
- BroadcastEvent trong VideoObject.
Vì vậy:
Không nên dùng Indexing API như mẹo để ép Google index hàng loạt bài blog.
Google tháng 09/2026 còn cập nhật tài liệu để làm rõ rằng việc gửi URL qua Indexing API vẫn chịu spam detection.
robots.txt có ngăn Index không?
Đây là câu hơi ngược đời.
robots.txt chủ yếu kiểm soát crawling.
Nó không phải công cụ đáng tin cậy để yêu cầu Google bỏ URL khỏi index.
Nếu một URL bị robots.txt chặn nhưng Google biết URL qua link bên ngoài, URL vẫn có khả năng xuất hiện trong Search mà Google không có nội dung để hiển thị đầy đủ.
Nếu thực sự không muốn một trang được index:
meta robots noindexhoặc:
X-Robots-Tag: noindexthường phù hợp hơn.
Nhưng có một điều thú vị:
Muốn Google đọc được noindex thì Google phải được phép crawl trang đó.
Nếu vừa:
Disallow trong robots.txtvừa:
noindex trong HTMLGoogle có thể không crawl để nhìn thấy noindex.
Noindex và Canonical có nên dùng cùng lúc?
Nha tránh tạo tín hiệu mâu thuẫn không cần thiết.
Ví dụ:
noindex + canonical → URL khácmột bên nói:
Đừng index tôi.
bên kia nói:
Hãy xem URL kia là đại diện.
Có những tình huống kỹ thuật đặc biệt, nhưng nếu mục tiêu rõ thì Nha thích chọn công cụ rõ.
Duplicate → canonical.
Không muốn xuất hiện → noindex.
URL đã chuyển → redirect.
HTTP Status cũng quyết định khả năng Index
Google nói một trang đủ điều kiện index cần trả:
HTTP 200Nếu URL trả:
- 404;
- 410;
- 5xx;
thì Google sẽ không index như một trang nội dung bình thường.
Đặc biệt cần để ý:
Soft 404.
Ví dụ trang nói:
Không tìm thấy sản phẩm.
nhưng server vẫn trả:
200 OKGoogle có thể tự xem đây là soft 404.
Server nói:
“Trang tốt.”
Nội dung nói:
“Không có gì ở đây.”
Google lại phải đoán.
Indexing và JavaScript
Google có thể render JavaScript bằng Chrome trong quá trình crawl/index.
Nhưng nếu nội dung quan trọng:
- chỉ xuất hiện sau một API call lỗi;
- cần tương tác;
- render quá chậm;
- hoặc Googlebot không tải được resource;
thì Google có thể không thấy cùng nội dung mà người dùng thấy.
Với website server-rendered như nhiều trang của manhtunha.com, câu chuyện thường đơn giản hơn.
Nhưng với Next.js, SPA hay các hệ thống JS-heavy thì đây là phần Nha nghĩ nên có một bài riêng.
“Page with redirect” có cần sửa không?
Nếu redirect là chủ ý thì:
không.
URL redirect không cần được index.
Google sẽ tập trung vào URL đích.
Nhưng cần kiểm tra nếu:
- redirect sai đích;
- redirect chain;
- sitemap vẫn chứa URL cũ;
- Internal Link vẫn link URL redirect.
Đây là ví dụ rất hay cho nguyên tắc:
Not Indexed không đồng nghĩa Error.
“Alternate page with proper canonical tag” có cần sửa không?
Nếu canonical đúng:
không.
Đó chính là kết quả mong muốn.
Google hiểu URL này là phiên bản phụ và canonical URL khác là đại diện.
Đừng cố làm nó index chỉ để giảm số lượng Not Indexed.
“Duplicate, Google chose different canonical than user” thì sao?
Cái này đáng kiểm tra hơn.
Nha đã dành cả bài Canonical URL là gì? Vì sao Google chọn URL khác? để nói về trường hợp này.
Cần xem:
- canonical;
- sitemap;
- Internal Link;
- redirect;
- HTTPS;
- www/non-www;
- nội dung;
- và tín hiệu nào đang mâu thuẫn.
404 có phải cứ thấy là phải Redirect?
Không.
Nếu một URL:
- đã bị xóa;
- không còn nội dung thay thế tương đương;
- và không còn được Internal Link;
thì trả 404 hoặc 410 có thể hoàn toàn hợp lý.
Nha không redirect mọi 404 về homepage.
Ví dụ:
/bai-cu-da-xoa 301 → /chỉ để Search Console đẹp hơn.
Đó có thể tạo ra trải nghiệm kém và soft 404.
Cách Nha đọc Page Indexing Report
Nha không bắt đầu bằng con số:
Bao nhiêu URL Not Indexed?
Nha bắt đầu bằng:
Những URL nào đáng được index nhưng đang không được index?
Sau đó chia thành nhóm.
Nhóm A – Không cần sửa
- redirect;
- alternate canonical;
- URL intentionally noindex;
- 404 thật;
- duplicate không cần index.
Nhóm B – Cần kiểm tra kỹ thuật
- blocked by robots.txt ngoài ý muốn;
- server error;
- soft 404;
- canonical sai;
- redirect sai;
- noindex ngoài ý muốn.
Nhóm C – Cần xem lại discovery/crawl
- Discovered - currently not indexed;
- orphan page;
- Internal Link yếu;
- URL không trong sitemap;
- site sinh quá nhiều URL phụ.
Nhóm D – Cần xem lại chất lượng
- Crawled - currently not indexed;
- thin tag page;
- near duplicate;
- content commodity;
- nội dung không có vai trò riêng.
Nha thấy cách chia này hữu ích hơn việc sửa lần lượt từng dòng trong Search Console.
Checklist xử lý một URL không được Index
Nha sẽ kiểm tra theo thứ tự này.
1. URL có thực sự cần Index không?
Nếu không thì dừng.
Đừng tối ưu thứ mình không cần.
2. HTTP Status
200?3. Googlebot có crawl được không?
Kiểm tra robots.txt và quyền truy cập.
4. Có noindex không?
HTML hoặc X-Robots-Tag.
5. Canonical là URL nào?
User-declared và Google-selected.
6. URL có trong Sitemap không?
Nếu đây là URL quan trọng.
7. Có Internal Link không?
Đặc biệt từ những trang liên quan và quan trọng.
8. Nội dung có khác các URL khác đủ nhiều không?
Kiểm tra duplicate và near duplicate.
9. Search Intent có rõ không?
Trang này đang giải quyết câu hỏi gì?
10. Nội dung có lý do tồn tại không?
Nếu bỏ URL này khỏi website, người đọc có mất đi điều gì không?
11. Google đã crawl chưa?
Phân biệt:
Discovered vs Crawled12. Sau khi sửa mới Request Indexing
Không request trước rồi mới nghĩ xem cần sửa gì.
Không phải URL nào cũng đáng cứu
Đây có lẽ là thay đổi lớn nhất trong cách Nha nhìn indexing.
Ngày trước:
Google không index → phải tìm cách index.
Bây giờ:
Google không index → trước tiên hỏi URL này có thực sự đáng index không.
Ví dụ tag page chỉ có một bài.
Search result page.
Filter page không có nhu cầu tìm kiếm.
URL parameter.
Trang cũ không còn giá trị.
Những trang đó không nhất thiết cần cứu.
Có khi hành động đúng lại là:
- noindex;
- canonical;
- redirect;
- merge;
- hoặc remove.
Index bloat là gì?
Index bloat là cách người làm SEO thường mô tả tình trạng Google index quá nhiều URL ít giá trị so với những trang thực sự quan trọng.
Ví dụ blog có:
500 bài viết + 3.000 tag/archive/filter/search URLvà hàng nghìn URL phụ đều indexable.
Đó chưa chắc là cấu trúc tốt.
Mục tiêu không phải:
Càng nhiều URL trong Google càng tốt.
Mà là:
Những URL đáng xuất hiện phải được index và những URL không cần thiết không gây nhiễu.
Áp vào manhtunha.com thì sao?
Những bài mới của blog gần đây được Google crawl khá nhanh.
Đó là tín hiệu tốt cho discovery và crawl.
Nhưng manhtunha.com đã tồn tại gần 10 năm nên còn một bài toán khác:
- tag cũ;
- category cũ;
- pagination;
- bài cũ;
- URL lịch sử;
- archive;
- và những URL Google biết từ nhiều năm trước.
Vì vậy Nha không muốn chỉ kiểm tra:
Bài mới có index nhanh không?
Nha muốn kiểm tra:
Toàn bộ inventory URL mà Google đang biết có còn phản ánh cấu trúc website hiện tại hay không?
Đây sẽ là một bài toán Content Audit + Technical SEO.
Google không Index một bài không có nghĩa bài dở
Cũng phải nói cho công bằng.
Indexing phụ thuộc nhiều yếu tố.
Một bài mới chưa index sau vài ngày chưa đủ để kết luận:
Google đánh giá bài chất lượng thấp.
Có thể chỉ là:
- chưa crawl;
- chưa xử lý xong;
- crawl priority;
- website mới;
- hay Search Console chưa cập nhật.
Đừng biến mỗi trạng thái Search Console thành một bản đánh giá đạo đức về nội dung. 😄
Crawl Budget có phải vấn đề của mọi website?
Không.
Google hiện nói hướng dẫn Crawl Budget nâng cao chủ yếu dành cho:
- website khoảng một triệu URL trở lên;
- website từ khoảng 10.000 URL nhưng thay đổi rất nhanh hàng ngày;
- hoặc site có lượng lớn URL nằm ở Discovered - currently not indexed.
Với một blog vài trăm hay vài nghìn URL được crawl ổn định, Nha không bắt đầu bằng:
Tối ưu Crawl Budget.
Nha bắt đầu bằng:
- URL inventory;
- Internal Link;
- Sitemap;
- content quality;
- canonical;
- và indexability.
Indexing trong thời AI Search có thay đổi gì không?
Có một nguyên tắc rất cơ bản vẫn không đổi:
Muốn một trang đủ điều kiện xuất hiện trong các trải nghiệm Google Search, trước hết Google phải có khả năng crawl và index trang đó.
AEO.
GEO.
AI Mode.
Tất cả nghe khá mới.
Nhưng nếu trang còn nằm ngoài index thì nói chuyện tối ưu presentation cho Search nghe hơi sớm.
Nha vẫn thích thứ tự:
URL ↓ Crawl ↓ Index ↓ Understand ↓ Quality / Trust ↓ Retrieve / Rank / ServeĐừng nhảy từ:
URLthẳng tới:
GEObỏ qua ba tầng ở giữa.
Điều Nha thay đổi trong cách nhìn về Indexing
Ngày trước:
Trang chưa index là vấn đề cần sửa.
Bây giờ:
Trang chưa index là một trạng thái cần hiểu.
Có URL nên index.
Có URL không nên index.
Có URL cần sửa kỹ thuật.
Có URL cần sửa nội dung.
Có URL nên merge.
Có URL nên bỏ.
Và có URL chỉ cần...
đợi một chút.
Google Search Console rất hữu ích.
Nhưng nó không thay mình đưa ra quyết định.
Nó cho biết:
Google đang nhìn URL này như thế nào.
Phần còn lại của người làm website là hỏi:
Google nhìn như vậy có đúng với mục đích của URL không?
Bạn nên mang gì về sau bài này?
- Crawling, Indexing và Ranking là ba việc khác nhau.
- Google crawl một URL không đồng nghĩa Google phải index URL đó.
- Đáp ứng yêu cầu kỹ thuật tối thiểu chỉ giúp URL đủ điều kiện index, không đảm bảo index.
- Không cần 100% URL website được index.
- Discovered - currently not indexed nghĩa là Google biết URL nhưng chưa crawl.
- Crawled - currently not indexed nghĩa là Google đã crawl nhưng hiện chưa index.
- Sitemap và Request Indexing không phải mệnh lệnh bắt Google index.
- Not Indexed không tự động có nghĩa là Error.
- Trước khi sửa một URL không index, hãy hỏi URL đó có thực sự cần index không.
- Nếu trang đã được crawl nhưng không index, đừng chỉ tiếp tục sửa kỹ thuật; hãy xem lại giá trị, tính độc đáo, duplicate và vai trò của nội dung.
Câu Nha muốn giữ lại nhất sau bài này là:
Đừng hỏi làm sao ép Google index mọi URL.
Hãy làm cho những URL đáng được index thật sự đáng tồn tại.
Nghe đơn giản.
Nhưng càng audit website lâu năm, Nha càng thấy đây mới là phần khó.
Nguồn và tài liệu tham khảo
Nha ưu tiên tài liệu chính thức của Google và kiểm tra lại vào tháng 11/2026.
- Google Search Central - How Google Search Works
Google giải thích ba giai đoạn Crawling, Indexing và Serving, đồng thời nói rõ không phải mọi trang được xử lý đều chắc chắn được index. - Google Search Central - Technical requirements
Google nêu ba yêu cầu kỹ thuật tối thiểu để một trang đủ điều kiện index: Googlebot không bị chặn, HTTP 200 và có nội dung indexable; đồng thời nhấn mạnh đáp ứng đủ vẫn không đảm bảo được index. - Google Search Console Help - Page Indexing Report
Tài liệu chính thức giải thích các trạng thái Indexed và Not Indexed, các nguyên nhân phổ biến và cách sử dụng URL Inspection để điều tra từng URL. - Google Search Console Help - Has Google found all your pages?
Google khuyến nghị tập trung vào việc các trang quan trọng và canonical URL được index thay vì cố đạt 100% coverage. - Google Search Central - Troubleshoot crawling errors
Tài liệu hướng dẫn kiểm tra crawl, server capacity, sitemap, Internal Link và những URL không cần Google crawl. - Google Search Central - Crawling and Indexing FAQ
Google giải đáp các câu hỏi phổ biến về thời gian crawl/index, sitemap, recrawl và lý do trang có thể chưa được index. - Google - Crawl Budget Management
Google giải thích crawl budget chủ yếu đáng quan tâm với website rất lớn, website thay đổi nhanh hoặc site có lượng lớn URL ở trạng thái Discovered - currently not indexed. - Google Search Central - Latest Search Documentation Updates
Changelog chính thức. Tháng 09/2026 Google làm rõ việc sử dụng Indexing API chịu spam detection và tháng 10/2026 tiếp tục cập nhật các tài liệu liên quan crawling và indexing.
Lưu ý: Page Indexing Report là công cụ chẩn đoán trạng thái của URL, không phải bảng điểm SEO. Một URL không được index có thể là lỗi cần sửa, nhưng cũng có thể là kết quả hoàn toàn đúng nếu URL đó là duplicate, redirect, noindex hoặc không có lý do để xuất hiện trong Google Search.
Cảm ơn bạn đã đọc hết bài viết!
Bài viết sau
Giới thiệu
- Nguyễn Văn Nha
- Mãnh Tử Nha
- 11/07
- Developer - Blogger - Marketer
- Đồng Văn Cống, Thành phố Hồ Chí Minh
- Chat ngay
- 0393 314 999
- [email protected]
- Follow me on Facebook
- Follow me on twitter
- Mãnh Tử Nha Channel
- Follow me on Linkedin
- Follow me on Zalo
- Follow me on Tiktok
- Follow me on Strava
- www.manhtunha.com
- www.NHA.one
Tìm kiếm Google
Tài trợ
Bài viết mới nhất
 Indexing là gì? Vì sao Google đã crawl bài nhưng vẫn không lập chỉ mục?
 Nhịp tim khi chạy bộ: Vì sao cùng một pace mà hôm nay tim lại đập nhanh hơn?
 Chạy bộ nên thở bằng mũi hay miệng? Cách thở đúng
 Khẩu độ là gì? Vì sao f/1.8 khác f/8 và khi nào nên sử dụng?
 Người mới bắt đầu chụp ảnh nên học gì trước khi mua máy ảnh?
Có thể bạn thích
Xem nhiều nhất


Liên kết


