Outlier là gì? Cách nhận biết và xử lý giá trị ngoại lệ trong dữ liệu
Outlier hay giá trị ngoại lệ là một quan sát khác biệt đáng kể so với phần lớn các giá trị còn lại trong tập dữ liệu.
Ví dụ:
10 11 12 13 100
Giá trị 100 khác khá xa so với bốn giá trị còn lại.
Nó có thể được xem là một outlier cần được kiểm tra.
Nhưng điều quan trọng là:
Outlier không mặc định là dữ liệu sai.
Giá trị 100 có thể là lỗi nhập liệu.
Nó cũng có thể là một quan sát hoàn toàn có thật.
Ví dụ một khách hàng mua đơn hàng rất lớn hoặc một request thật sự mất 30 giây để phản hồi.
Hai trường hợp cần cách xử lý hoàn toàn khác nhau.
Vì vậy khi phát hiện outlier câu hỏi đầu tiên không nên là:
Xóa nó thế nào?
Mà nên là:
Vì sao giá trị này xuất hiện?
Outlier có thể xuất hiện từ nhiều nguyên nhân.
Một nguyên nhân đơn giản là lỗi nhập dữ liệu.
Ví dụ tuổi khách hàng được nhập thành 250 thay vì 25.
Đây có thể là vấn đề Data Quality.
Outlier cũng có thể xuất hiện từ lỗi đo lường.
Một cảm biến gặp lỗi có thể tạo ra giá trị bất thường.
Một API trả sai đơn vị cũng có thể khiến dữ liệu lớn hơn hoặc nhỏ hơn hàng nghìn lần so với bình thường.
Nhưng outlier cũng có thể phản ánh một sự kiện thật sự đặc biệt.
Ví dụ một ngày doanh thu tăng mạnh vì có chiến dịch lớn.
Một khách hàng doanh nghiệp mua số lượng lớn.
Một server phản hồi rất chậm vì hệ thống gặp sự cố.
Những dữ liệu này không nên bị xóa chỉ vì khác phần còn lại.
Đôi khi chính outlier mới là thứ đáng điều tra nhất.
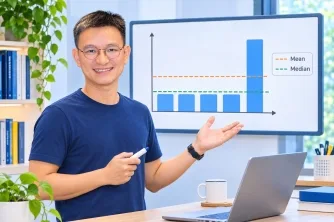
Outlier có thể ảnh hưởng mạnh đến trung bình cộng.
Ví dụ:
10 11 12 13 100
Mean bằng 29.2.
Trong khi median chỉ bằng 12.
Giá trị 100 kéo mean lên rất mạnh.
Đây là lý do median thường được xem cùng mean khi dữ liệu có khả năng bị lệch hoặc có outlier.
Tuy nhiên không nên hiểu rằng median luôn tốt hơn mean.
Nếu giá trị ngoại lệ là dữ liệu thật và có tác động thực tế thì mean vẫn chứa thông tin quan trọng.
Ví dụ một vài giao dịch cực lớn vẫn thực sự đóng góp vào tổng doanh thu.
Nếu bỏ qua chúng chỉ để báo cáo nhìn “ổn định hơn” thì kết luận có thể sai.
Outlier cũng ảnh hưởng đến standard deviation và variance.
Do các chỉ số này phụ thuộc khoảng cách giữa các giá trị và mean nên một vài giá trị cực đoan có thể làm mức phân tán tăng đáng kể.
Đây là lý do khi nhìn standard deviation nên xem thêm distribution.
Một trong những cách đơn giản để phát hiện outlier là quan sát dữ liệu.
Histogram scatter plot và box plot có thể giúp nhận ra những điểm nằm xa phần lớn quan sát.
Box plot đặc biệt thường được dùng để hỗ trợ nhận biết outlier.
Một phương pháp phổ biến dựa trên Interquartile Range hay IQR.
IQR được tính:
IQR = Q3 - Q1
Một quy tắc thường gặp là xem xét những giá trị nhỏ hơn:
Q1 - 1.5 × IQR
hoặc lớn hơn:
Q3 + 1.5 × IQR
như các giá trị ngoại lệ tiềm năng.
Từ “tiềm năng” rất quan trọng.
Đây là quy tắc phát hiện để điều tra.
Nó không phải luật bắt buộc phải xóa dữ liệu.
Một phương pháp khác là sử dụng Z-score.
Z-score mô tả một giá trị nằm cách mean bao nhiêu standard deviation.
Những giá trị có Z-score rất lớn hoặc rất nhỏ có thể được xem xét như outlier.
Nhưng phương pháp này phù hợp hơn khi cấu trúc distribution và các giả định liên quan đủ hợp lý.
Nếu dữ liệu bị skew mạnh thì cách dùng ngưỡng Z-score đơn giản có thể tạo ra kết quả không phù hợp.
Đây là lý do không có một công thức outlier duy nhất đúng cho mọi dataset.
Domain knowledge rất quan trọng.
Ví dụ một khách hàng 150 tuổi gần như chắc chắn cần được kiểm tra.
Nhưng một đơn hàng 150 triệu đồng có phải outlier hay không còn phụ thuộc ngành hàng và loại khách hàng.
Con số chỉ cho biết giá trị khác biệt.
Nghiệp vụ mới giúp giải thích nó có hợp lý hay không.
Outlier cũng cần được phân biệt với anomaly.
Hai khái niệm có vùng giao nhau nhưng không hoàn toàn giống nhau.
Outlier thường nhấn mạnh một quan sát nằm xa phần lớn distribution.
Anomaly thường nhấn mạnh hành vi bất thường so với pattern được mong đợi.
Ví dụ một giao dịch 10 triệu có thể hoàn toàn bình thường trong toàn bộ dataset.
Nhưng nếu một tài khoản trước đây chỉ giao dịch vài trăm nghìn rồi đột nhiên thực hiện nhiều giao dịch 10 triệu lúc 3 giờ sáng thì hành vi đó có thể là anomaly.
Giá trị tự nó chưa chắc là outlier.
Pattern mới là thứ bất thường.
Outlier cũng có thể xuất hiện trong time series.
Ví dụ traffic website thường quanh 100000 lượt mỗi ngày rồi một ngày tăng lên 800000.
Điều này có thể là lỗi tracking.
Nó cũng có thể là một chiến dịch viral.
Hoặc bot traffic.
Không thể biết chỉ từ con số.
Cần xem context.
Seasonality cũng có thể làm một giá trị trông giống outlier nếu so sánh sai.
Ví dụ doanh thu dịp Tết cao hơn nhiều ngày bình thường nhưng có thể hoàn toàn hợp lý với đặc điểm kinh doanh.
So với ngày bình thường nó là cực đoan.
So với cùng kỳ các năm trước thì có thể rất bình thường.
Đây là lý do phát hiện outlier phải dựa trên baseline phù hợp.
Khi xác định một outlier có vài cách xử lý.
Đầu tiên là giữ nguyên.
Nếu dữ liệu đúng và phản ánh một sự kiện thật thì giữ lại thường là lựa chọn hợp lý.
Cách thứ hai là sửa dữ liệu.
Nếu xác định rõ đó là lỗi nhập liệu và có nguồn đáng tin để khôi phục giá trị đúng thì có thể sửa.
Cách thứ ba là loại bỏ.
Việc loại bỏ chỉ nên thực hiện khi có lý do rõ và có thể giải thích.
Ví dụ một bản ghi do hệ thống test tạo ra vô tình lọt vào production analytics.
Cách thứ tư là tách riêng để phân tích.
Một nhóm khách hàng có giá trị cực cao có thể xứng đáng trở thành một segment riêng thay vì bị xóa khỏi dataset.
Cách thứ năm là sử dụng các phương pháp thống kê ít nhạy với outlier.
Ví dụ sử dụng median thay mean trong một số bài toán mô tả xu hướng trung tâm.
Nhưng đây không phải cách “xử lý mất outlier”.
Nó chỉ thay đổi cách tóm tắt dữ liệu.
Winsorization là một kỹ thuật khác đôi khi được sử dụng.
Thay vì loại bỏ hoàn toàn những giá trị cực đoan người phân tích có thể giới hạn chúng ở một ngưỡng nhất định.
Tuy nhiên thao tác này thay đổi dữ liệu.
Do đó cần có lý do phương pháp và tài liệu giải thích rõ.
Không nên winsorize chỉ vì kết quả mô hình đẹp hơn.
Trong Machine Learning outlier có thể ảnh hưởng mạnh đến một số thuật toán.
Một số mô hình nhạy với khoảng cách hoặc scale có thể bị tác động bởi những giá trị cực đoan.
Nhưng không phải mọi model đều phản ứng giống nhau.
Vì vậy preprocessing cần phù hợp với thuật toán và bài toán thực tế.
Outlier còn liên quan đến fraud detection.
Một giao dịch khác biệt so với hành vi thông thường có thể là tín hiệu đáng kiểm tra.
Nhưng khác biệt không đồng nghĩa gian lận.
Nếu hệ thống mặc định mọi outlier là fraud thì false positive có thể rất cao.
Cần thêm nhiều tín hiệu khác để đánh giá.
Outlier cũng rất quan trọng trong monitoring hệ thống.
Latency CPU error rate hoặc số lượng transaction tăng bất thường có thể cho thấy sự cố.
Nhưng threshold cố định đôi khi không đủ.
Một mức CPU 80 phần trăm có thể bình thường vào giờ cao điểm nhưng bất thường lúc 3 giờ sáng.
Bối cảnh vẫn là chìa khóa.
Một lỗi phổ biến trong phân tích là xóa outlier trước rồi mới tìm hiểu.
Điều này có thể loại bỏ chính những thông tin có giá trị nhất.
Một lỗi khác là giữ tất cả outlier với lý do “đó là dữ liệu thật”.
Dữ liệu thật vẫn có thể cần xử lý khác tùy mục đích phân tích.
Ví dụ một sự kiện đặc biệt không đại diện cho hoạt động bình thường có thể cần được tách riêng khi dự báo.
Điều quan trọng là quyết định phải có lý do.
Một quy trình đơn giản có thể là:
Phát hiện → xác minh → tìm nguyên nhân → đánh giá tác động → quyết định giữ sửa loại bỏ hoặc tách riêng → ghi lại cách xử lý.
Bước ghi lại rất quan trọng.
Nếu một analyst xóa 27 dòng dữ liệu mà không ghi lý do thì vài tháng sau rất khó biết kết quả được tạo ra từ dataset nào.
Data lineage và reproducibility vì vậy cũng liên quan đến việc xử lý outlier.
Một câu hỏi hữu ích khi gặp outlier là:
Nó là lỗi dữ liệu hay là một phần của thực tế mà mình chưa hiểu?
Sau đó mới hỏi:
Nếu giữ nó thì kết luận thay đổi thế nào?
Nếu loại nó thì kết luận thay đổi thế nào?
So sánh hai kết quả đôi khi giúp nhận ra mức độ nhạy của phân tích đối với những giá trị cực đoan.
Outlier vì vậy không phải rác dữ liệu.
Nó là một tín hiệu cần điều tra.
Đôi khi tín hiệu đó cho biết dữ liệu sai.
Đôi khi nó cho biết hệ thống gặp sự cố.
Và đôi khi nó cho biết vừa có một điều rất thú vị xảy ra.
Tag Outlier tổng hợp các bài viết và kiến thức về giá trị ngoại lệ IQR Z-score box plot mean median Data Quality anomaly và cách phát hiện đánh giá xử lý outlier đúng trong thống kê và phân tích dữ liệu.