English (EN)

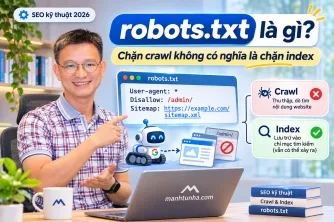
robots.txt là gì? Cách kiểm soát crawler mà không chặn nhầm Google
robots.txt là một file văn bản được đặt ở thư mục gốc của website để cung cấp quy tắc cho crawler về những khu vực chúng được phép hoặc không được phép truy cập.
Ví dụ:
https://example.com/robots.txt
robots.txt là một phần của Robots Exclusion Protocol.
Vai trò chính của nó là kiểm soát crawling.
Điểm này rất quan trọng.
robots.txt không phải công cụ chính để yêu cầu Google không index một trang.
Crawling và indexing là hai quá trình khác nhau.
Crawling là việc crawler truy cập và tải nội dung của URL.
Indexing là quá trình công cụ tìm kiếm xử lý và có thể lưu thông tin của URL vào index.
Một URL bị chặn crawling bằng robots.txt vẫn có thể được Google biết đến thông qua internal link backlink sitemap hoặc nguồn khác.
Trong một số trường hợp URL đó vẫn có thể xuất hiện trong kết quả tìm kiếm dù Google không crawl được nội dung của trang.
Vì vậy nếu mục tiêu thực sự là:
Không muốn trang xuất hiện trên Google Search
thì cần xem xét noindex thay vì chỉ sử dụng robots.txt.
Nhưng có một điểm dễ làm sai.
Nếu một URL vừa bị robots.txt chặn crawling vừa chứa meta robots noindex thì Google có thể không crawl được trang để nhìn thấy noindex.
Do đó nếu muốn Google đọc noindex thì crawler phải có khả năng truy cập URL đó.
Đây là một trong những lỗi Technical SEO khá phổ biến.
Người quản trị muốn loại trang khỏi index.
Họ thêm noindex.
Sau đó lại chặn luôn URL trong robots.txt.
Kết quả là crawler không thể đọc directive vừa được thêm vào.
robots.txt cũng không phải hệ thống bảo mật.
Nội dung của file robots.txt là công khai.
Bất kỳ ai cũng có thể mở file này.
Vì vậy không nên viết:
Disallow: /secret-admin/
rồi nghĩ thư mục đó đã được bảo vệ.
Thậm chí việc khai báo còn có thể giúp người khác biết đường dẫn tồn tại.
Nếu một tài nguyên cần bảo mật hãy sử dụng authentication authorization firewall hoặc biện pháp bảo mật phù hợp.
robots.txt chỉ là quy tắc dành cho crawler tuân thủ protocol.
Một file cơ bản có thể có dạng:
User-agent: *
Disallow: /admin/
Sitemap: https://example.com/sitemap.xml
User-agent xác định crawler mà nhóm quy tắc áp dụng.
Dấu sao thường được sử dụng để đại diện cho các crawler không có nhóm cụ thể phù hợp hơn.
Disallow xác định path mà crawler không được phép crawl.
Ví dụ:
Disallow: /admin/
có thể được sử dụng để yêu cầu crawler không truy cập những URL thuộc path `/admin/`.
Allow có thể được sử dụng để cho phép crawler truy cập một path cụ thể nằm trong phạm vi rộng hơn đang bị Disallow.
Ví dụ:
User-agent: *
Disallow: /folder/
Allow: /folder/public/
Ý tưởng ở đây là chặn phần lớn `/folder/` nhưng vẫn cho phép crawl `/folder/public/`.
Các crawler có thể có quy tắc matching cụ thể.
Với Google quy tắc phù hợp cụ thể nhất sẽ được ưu tiên khi xác định URL được Allow hay Disallow.
Vì vậy không nên suy luận robots.txt chỉ bằng thứ tự dòng từ trên xuống dưới.
Sitemap cũng thường được khai báo trong robots.txt.
Ví dụ:
Sitemap: https://example.com/sitemap.xml
Dòng này giúp crawler biết vị trí của XML Sitemap.
Nhưng sitemap và robots.txt làm hai việc khác nhau.
Sitemap giúp công cụ tìm kiếm khám phá những URL mà website muốn cung cấp.
robots.txt kiểm soát khu vực crawler có thể truy cập.
Không nên nghĩ sitemap là danh sách URL bắt buộc index.
Cũng không nên nghĩ URL không có trong sitemap sẽ không được Google crawl.
Google vẫn có thể khám phá URL từ liên kết.
robots.txt phải được đặt đúng vị trí.
Thông thường nó nằm ngay tại root của host.
Ví dụ:
https://www.example.com/robots.txt
Không phải:
https://www.example.com/folder/robots.txt
File đặt trong thư mục con không kiểm soát toàn bộ host theo cách một robots.txt chuẩn ở root thực hiện.
Phạm vi của robots.txt cũng phụ thuộc vào host protocol và port mà file được phục vụ.
robots.txt của:
https://example.com/
không mặc định là robots.txt của:
https://sub.example.com/
Subdomain có thể cần robots.txt riêng.
Điều này rất quan trọng với những hệ thống sử dụng nhiều subdomain.
Ví dụ:
www.example.com
media.example.com
shop.example.com
api.example.com
Mỗi host có thể có yêu cầu crawling khác nhau.
Path trong robots.txt có phân biệt chữ hoa chữ thường.
Ví dụ `/News/` và `/news/` có thể là hai path khác nhau.
Điều này đặc biệt quan trọng trên những hệ thống URL có case không nhất quán.
Một lỗi nhỏ trong robots.txt có thể ảnh hưởng tới rất nhiều URL.
Ví dụ:
Disallow: /
có thể chặn crawler khỏi toàn bộ website đối với user-agent tương ứng.
Đây là một dòng rất ngắn.
Ảnh hưởng thì không ngắn chút nào.
Nó đôi khi xuất hiện khi website staging được chuyển lên production nhưng robots.txt của môi trường test vẫn còn nguyên.
Đây là lý do robots.txt nên nằm trong checklist go-live.
Trước khi triển khai website cần kiểm tra:
robots.txt.
Meta robots.
Canonical.
HTTP status.
XML Sitemap.
Khả năng render.
Và khả năng Googlebot truy cập các tài nguyên cần thiết.
Không nên chặn CSS và JavaScript một cách máy móc.
Google có thể cần những tài nguyên này để render trang.
Nếu crawler không tải được JavaScript hoặc CSS quan trọng thì Google có thể nhìn trang khác với người dùng.
Do đó trước khi block thư mục asset cần hiểu các file trong đó được sử dụng để làm gì.
robots.txt cũng có thể hữu ích để kiểm soát một số URL space không cần crawl.
Ví dụ website có thể sinh ra rất nhiều URL từ:
Filter.
Sort.
Search nội bộ.
Calendar.
Session parameter.
Hoặc faceted navigation.
Nếu những URL này tạo ra không gian gần như vô hạn crawler có thể dành nhiều tài nguyên vào những URL ít giá trị.
Trong một số trường hợp robots.txt có thể được sử dụng như một phần của giải pháp kiểm soát crawling.
Nhưng không nên dùng một directive đơn giản để chữa mọi vấn đề URL.
Cấu trúc URL internal linking canonical nofollow và cách hệ thống tạo link cũng cần được xem xét.
Ví dụ website tạo ra hàng triệu URL filter không cần thiết.
Block chúng bằng robots.txt có thể giảm crawling.
Nhưng nếu hệ thống vẫn liên tục tạo và liên kết tới chúng thì nguyên nhân gốc vẫn tồn tại.
Technical SEO tốt nên xử lý cả nguồn sinh URL.
robots.txt và canonical cũng làm hai việc khác nhau.
Canonical giúp công cụ tìm kiếm hiểu URL nào được ưu tiên trong một nhóm nội dung tương tự hoặc trùng lặp.
robots.txt chỉ kiểm soát crawl.
Nếu block một URL bằng robots.txt Google có thể không crawl được trang để nhìn thấy canonical nằm trong HTML.
Vì vậy robots.txt không phải công cụ thay thế canonical.
robots.txt và nofollow cũng khác nhau.
robots.txt áp dụng ở cấp URL crawling.
nofollow là một hint liên quan tới việc theo liên kết.
Hai cơ chế không thể thay thế trực tiếp cho nhau.
robots.txt và HTTP status cũng khác nhau.
Nếu một URL không còn tồn tại hãy trả trạng thái phù hợp như 404 hoặc 410 khi đúng trường hợp.
Không nên chỉ Disallow URL rồi để server tiếp tục trả 200.
Block crawl không nói rằng tài nguyên đã bị xóa.
robots.txt cũng không phải công cụ xóa URL khẩn cấp khỏi Google.
Nếu nội dung đã index cần xem xét phương án phù hợp như noindex xóa URL trả HTTP status thích hợp hoặc công cụ removal tùy tình huống.
Chỉ thêm Disallow chưa chắc làm URL biến mất khỏi kết quả tìm kiếm.
Crawl Budget là chủ đề thường được nhắc cùng robots.txt.
Website rất lớn có thể quan tâm tới việc crawler dành tài nguyên cho những URL nào.
robots.txt có thể hỗ trợ kiểm soát một số khu vực không cần crawl.
Nhưng website nhỏ không nên ám ảnh crawl budget tới mức block hàng loạt URL có giá trị.
Trước hết cần xác định website thực sự có vấn đề crawling hay không.
Không phải cứ có 10000 URL là phải tối ưu crawl budget bằng robots.txt.
Crawl-delay cũng là directive thường gây nhầm lẫn.
Một số crawler có thể hỗ trợ nó.
Google không sử dụng crawl-delay trong robots.txt.
Do đó thêm:
Crawl-delay: 10
không phải cách kiểm soát tốc độ Googlebot.
Khi cấu hình crawler cụ thể cần kiểm tra tài liệu chính thức của crawler đó thay vì giả định mọi bot hiểu cùng một directive.
Không phải bot nào cũng tuân thủ robots.txt.
Robots Exclusion Protocol dựa trên việc crawler thực hiện các quy tắc được công bố.
Một bot độc hại có thể bỏ qua chúng.
Đây là thêm một lý do robots.txt không nên được dùng làm biện pháp bảo mật.
Nếu cần chặn traffic thực sự hãy xử lý ở server CDN WAF hoặc lớp bảo mật phù hợp.
User-agent cụ thể có thể được dùng khi muốn đặt quy tắc khác cho từng crawler.
Ví dụ:
User-agent: Googlebot
Disallow: /example/
Nhưng trước khi tạo nhiều nhóm bot nên có lý do rõ ràng.
Một robots.txt dài với hàng chục user-agent riêng rất dễ bị cấu hình sai.
Đơn giản thường tốt hơn.
Google cũng giới hạn lượng nội dung robots.txt được xử lý.
Nếu file trở nên cực lớn thì đó thường là dấu hiệu cấu trúc rule cần được xem lại.
Không nên tạo một dòng Disallow cho hàng trăm nghìn URL riêng lẻ nếu có thể mô tả chúng bằng cấu trúc path hợp lý.
robots.txt nên được quản lý như code cấu hình quan trọng.
Không nên sửa trực tiếp trên production mà không kiểm tra.
Một thay đổi nhỏ có thể ảnh hưởng toàn site.
Nếu có điều kiện nên lưu robots.txt trong version control.
Mọi thay đổi quan trọng nên có:
Lý do.
Người thay đổi.
Ngày triển khai.
Phạm vi URL bị ảnh hưởng.
Và phương án rollback.
Điều này đặc biệt quan trọng với website thương mại điện tử hoặc website có nhiều traffic organic.
Staging environment là nơi robots.txt thường được sử dụng để hạn chế crawler.
Nhưng chỉ robots.txt vẫn không phải phương án bảo mật tốt cho staging.
Nếu môi trường test không nên công khai thì authentication thường an toàn hơn.
robots.txt có thể là thêm một lớp hướng dẫn crawler.
Không phải lớp bảo vệ chính.
Một lỗi go-live kinh điển là:
Staging có:
User-agent: *
Disallow: /
Sau đó copy nguyên cấu hình sang production.
Website lên thật.
Googlebot thì đứng ngoài cửa.
Đây là lý do kiểm tra robots.txt sau deployment quan trọng hơn việc nhớ kiểm tra nó trước deployment.
Monitoring cũng cần thiết.
Sau khi thay đổi robots.txt nên theo dõi:
Server log.
Crawl behavior.
Page indexing.
Organic visibility.
Và những nhóm URL bị tác động.
Không nên triển khai một thay đổi lớn rồi chỉ kiểm tra xem file có mở được hay không.
Server log đặc biệt hữu ích vì cho biết crawler thực sự đang request URL nào.
robots.txt là quy tắc dự kiến.
Log cho thấy hành vi thực tế.
Khi điều tra vấn đề crawling hai nguồn này nên được xem cùng nhau.
Một quy trình kiểm tra robots.txt có thể bắt đầu như sau:
Xác định URL cần crawl → xác định URL không cần crawl → kiểm tra rule → kiểm tra matching → kiểm tra tài nguyên render → kiểm tra sitemap → kiểm tra HTTP response → triển khai → theo dõi crawling và indexing.
Trước khi thêm một dòng Disallow nên tự hỏi:
Tại sao crawler không nên truy cập URL này?
URL này có cần index không?
Google có cần crawl nó để nhìn noindex hoặc canonical không?
Có internal link đang trỏ tới nó không?
Có phải vấn đề thật sự nằm ở việc website tạo quá nhiều URL không?
Rule này có vô tình match URL quan trọng khác không?
CSS JavaScript hoặc hình ảnh cần render có bị chặn không?
Nếu xóa rule này crawler sẽ làm gì?
Những câu hỏi đó quan trọng hơn việc thuộc cú pháp robots.txt.
Cú pháp khá đơn giản.
Hậu quả cấu hình sai thì không đơn giản.
Một website có thể có nội dung rất tốt canonical đúng sitemap sạch structured data đầy đủ nhưng nếu Googlebot không thể crawl những trang quan trọng thì tất cả phần còn lại khó phát huy tác dụng.
robots.txt vì vậy là một file nhỏ nhưng nằm ở vị trí rất nhạy cảm trong Technical SEO.
Không cần viết nhiều rule.
Cần viết đúng rule.
Tag robots.txt tổng hợp các bài viết và kiến thức về Robots Exclusion Protocol Googlebot crawling Allow Disallow Sitemap crawl budget noindex canonical và cách cấu hình robots.txt an toàn trong Technical SEO.