 English (EN)

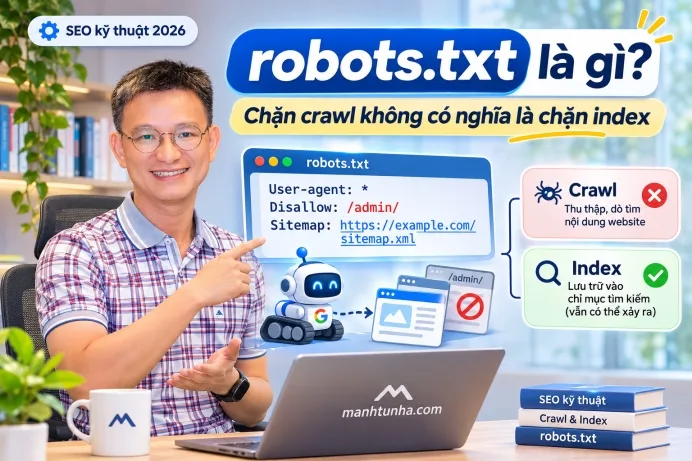
robots.txt là gì? Chặn Google crawl không có nghĩa là chặn Google index
Xem nhanh:
- robots.txt là gì?
- robots.txt dùng để làm gì?
- robots.txt không phải noindex
- Muốn trang không được Index thì dùng gì?
- Muốn Google đọc noindex thì đừng chặn Google bằng robots.txt
- robots.txt cũng không phải công cụ bảo mật
- robots.txt nằm ở đâu?
- Subdomain có cần robots.txt riêng không?
- Một robots.txt đơn giản trông thế nào?
- User-agent là gì?
- Disallow là gì?
- Allow là gì?
- Nếu Allow và Disallow xung đột thì sao?
- robots.txt hỗ trợ wildcard không?
- Có nên dùng Crawl-delay không?
- Sitemap có nên khai trong robots.txt không?
- robots.txt và Sitemap có chức năng ngược nhau không?
- robots.txt có nên chặn URL parameter không?
- Có nên chặn Search Result nội bộ?
- Có nên chặn Admin bằng robots.txt?
- Có nên chặn CSS và JavaScript?
- robots.txt và JavaScript SEO
- robots.txt có giới hạn kích thước không?
- Google cache robots.txt bao lâu?
- Điều gì xảy ra nếu robots.txt trả 404?
- Điều gì xảy ra nếu robots.txt trả 5xx?
- Rule robots.txt có phân biệt chữ hoa chữ thường không?
- Google có hỗ trợ Noindex trong robots.txt không?
- Một file robots.txt tốt có cần dài không?
- Đừng chặn Pagination chỉ vì không muốn nó Index
- robots.txt và Crawl Budget
- robots.txt và AI Search năm 2026
- Google-Extended có phải Googlebot không?
- Cập nhật mới cuối 2026: AI training control trong robots.txt
- Search generative AI control lại là chuyện khác
- Vậy muốn xuất hiện trong AI Overviews thì robots.txt thế nào?
- Nha sẽ audit robots.txt như thế nào?
- Checklist robots.txt Nha sẽ dùng
- Ba cấu hình Nha đặc biệt sợ
- Áp vào manhtunha.com thì sao?
- robots.txt và bài Indexing của Nha
- robots.txt và Canonical
- robots.txt và Internal Link
- Điều Nha thay đổi trong cách nhìn robots.txt
- Bạn nên mang gì về sau bài này?
- Nguồn và tài liệu tham khảo
Có một dòng trong robots.txt nhìn rất quyền lực:
Disallow: /Một dấu gạch chéo.
Nhìn vô hại.
Nhưng nếu đặt sai chỗ, nó có thể nói với Googlebot:
Đừng crawl bất kỳ URL nào trên website này.
Khá mạnh.
Và cũng vì mạnh như vậy nên robots.txt là một trong những file Nha không thích chỉnh theo kiểu:
Thử xem sao.
Có một hiểu lầm còn phổ biến hơn:
Tôi Disallow URL trong robots.txt rồi thì Google sẽ không index URL đó nữa.
Không hẳn.
Google hiện nói rất rõ:
robots.txt chủ yếu dùng để quản lý crawling, không phải cơ chế để giữ một trang web ra khỏi Google Search.
Nếu muốn hiểu Technical SEO cho đúng, đây là một ranh giới rất đáng nhớ.
robots.txt → kiểm soát crawl

noindex → kiểm soát index

password / authentication → bảo vệ nội dung riêng tư
Ba việc.
Ba công cụ.
Đừng bắt một file robots.txt làm cả ba.
robots.txt là gì?
robots.txt là một file văn bản chứa các quy tắc cho crawler biết URL hoặc nhóm URL nào trên một host mà crawler được hoặc không được phép truy cập.
Ví dụ đơn giản:
User-agent: * Disallow: /admin/ Sitemap: https://example.com/sitemap.xmlCó thể hiểu:
User-agent: *– áp dụng cho các crawler phù hợp;Disallow: /admin/– không crawl các URL bắt đầu bằng đường dẫn này;Sitemap:– khai báo vị trí sitemap.
File này thường nằm tại:
https://example.com/robots.txtKhông phải:
https://example.com/seo/robots.txtnếu mục tiêu là kiểm soát toàn host.
robots.txt dùng để làm gì?
Nha thấy cách hiểu tốt nhất là:
robots.txt giúp quản lý những nơi crawler nên hoặc không nên đi.
Nó có thể hữu ích khi website có:
- URL tìm kiếm nội bộ;
- filter tạo ra rất nhiều URL;
- calendar hoặc infinite spaces;
- khu vực kỹ thuật không cần crawler;
- URL hành động như cart hoặc một số workflow;
- tài nguyên không muốn crawler tải;
- hay những vùng gây lãng phí crawl ở website lớn.
Nhưng nó không được thiết kế như một:
nút Remove from Google.
robots.txt không phải noindex
Đây là phần quan trọng nhất.
Giả sử Nha có URL:
https://example.com/private-pageTrong robots.txt:
User-agent: * Disallow: /private-pageGooglebot sẽ được yêu cầu không crawl nội dung URL đó.
Nhưng nếu Google biết URL này thông qua:
- Internal Link;
- Backlink;
- Sitemap cũ;
- hoặc URL đã được Google biết từ trước;
Google vẫn có thể biết URL tồn tại.
Trong một số trường hợp, URL vẫn có thể xuất hiện trong Search mà không có snippet đầy đủ.
Vì Google chưa được phép crawl nội dung.
Đây là chuyện khá ngược đời:
Chặn crawler đọc trang không đồng nghĩa làm cho crawler quên rằng URL tồn tại.
Muốn trang không được Index thì dùng gì?
Nếu mục tiêu là:
Tôi không muốn URL này xuất hiện trong Google Search.
thì công cụ phù hợp hơn thường là:
<meta name="robots" content="noindex">hoặc HTTP header:
X-Robots-Tag: noindexGoogle nói khi Googlebot crawl được trang và nhìn thấy noindex, trang sẽ bị loại khỏi Google Search.
Nhưng có một điều rất đáng nhớ.
Muốn Google đọc noindex thì đừng chặn Google bằng robots.txt
Ví dụ Nha làm cả hai:
robots.txt: Disallow: /private-pagevà trong HTML:
<meta name="robots" content="noindex">Trông có vẻ:
Chặn hai lớp cho chắc.
Nhưng thực tế:
robots.txt nói:
Đừng vào đây.
Còn meta robots nằm bên trong nói:
Nếu vào được thì nhớ noindex tôi nhé.
Google không crawl thì làm sao đọc dòng thứ hai?
Google Search Central nói rất rõ:
Để noindex có hiệu lực, URL phải không bị robots.txt chặn.
Đây là một trong những lỗi Technical SEO Nha thấy rất dễ mắc.
robots.txt cũng không phải công cụ bảo mật
Đây là lỗi nguy hiểm hơn SEO.
Giả sử có thư mục:
/backup-secret/Rồi viết:
Disallow: /backup-secret/Nha không xem đây là bảo mật.
File robots.txt là file công khai.
Ai cũng có thể mở:
example.com/robots.txtvà đọc:
Ồ, website này có thư mục /backup-secret/.
Hơi phản tác dụng.
Nếu dữ liệu thực sự riêng tư:
- authentication;
- authorization;
- password;
- firewall;
- hoặc cơ chế bảo mật phù hợp
mới là thứ cần dùng.
robots.txt chỉ nói với crawler tử tế:
Xin đừng crawl.
Nó không khóa cửa.
robots.txt nằm ở đâu?
Google yêu cầu file phải nằm ở thư mục cấp cao nhất của host.
Ví dụ:
https://manhtunha.com/robots.txtQuy tắc trong đó chỉ áp dụng cho đúng:
- protocol;
- host;
- port
mà file thuộc về.
Đây là chi tiết rất quan trọng với website sử dụng subdomain.
Subdomain có cần robots.txt riêng không?
Có thể cần.
Ví dụ:
https://example.com/ https://media.example.com/ https://shop.example.com/robots.txt tại:
https://example.com/robots.txtkhông tự động kiểm soát:
https://media.example.com/hay:
https://shop.example.com/Mỗi host là một phạm vi riêng.
Điều này khá đáng lưu ý nếu website dùng CDN ảnh hoặc nhiều subdomain.
Một robots.txt đơn giản trông thế nào?
Ví dụ blog bình thường không cần chặn gì đáng kể:
User-agent: * Disallow: Sitemap: https://example.com/sitemap.xmlDòng:
Disallow:không có path nghĩa là không chặn URL nào trong nhóm đó.
Nhưng thực tế nếu không cần rule nào thì robots.txt có thể còn đơn giản hơn.
User-agent là gì?
User-agent cho biết nhóm rule này áp dụng cho crawler nào.
Ví dụ:
User-agent: Googlebot Disallow: /test/áp dụng với Googlebot.
Còn:
User-agent: * Disallow: /test/áp dụng với các crawler phù hợp với wildcard *.
Nha thường không tạo hàng chục nhóm crawler nếu không có nhu cầu thật.
Đơn giản dễ audit hơn.
Disallow là gì?
Disallow định nghĩa path crawler không nên truy cập.
Ví dụ:
User-agent: * Disallow: /admin/có thể chặn:
/admin/ /admin/user /admin/settingsNhưng path là:
case-sensitive.
Ví dụ:
Disallow: /Admin/không nhất thiết giống:
/admin/Đây là chi tiết nhỏ nhưng đủ tạo bug.
Allow là gì?
Allow có thể mở lại một đường dẫn cụ thể bên trong vùng đã Disallow.
Ví dụ:
User-agent: * Disallow: /folder/ Allow: /folder/public/Tức là:
/folder/private/ → không crawl /folder/public/ → crawlGoogle sẽ so sánh các rule phù hợp và ưu tiên rule có path cụ thể hơn.
Nếu Allow và Disallow xung đột thì sao?
Google hiện áp dụng nguyên tắc:
Rule có path phù hợp dài hơn – tức cụ thể hơn – được ưu tiên.
Ví dụ:
Allow: /folder/public/ Disallow: /folder/Với URL:
/folder/public/articleAllow cụ thể hơn.
Nên Google có thể crawl.
Nếu hai rule có cùng độ cụ thể và xung đột, Google dùng rule ít hạn chế hơn.
Tức thường:
Allow.
robots.txt hỗ trợ wildcard không?
Google hỗ trợ một số pattern.
Dấu *
Khớp với chuỗi ký tự bất kỳ.
Ví dụ:
Disallow: /*?sort=có thể dùng để chặn những URL có pattern sort nhất định.
Dấu $
Đánh dấu kết thúc URL.
Ví dụ:
Disallow: /*.pdf$có thể khớp URL kết thúc bằng .pdf.
Nhưng Nha không thích viết pattern phức tạp khi chưa test kỹ.
Một wildcard sai có thể rộng hơn nhiều so với mình tưởng.
Có nên dùng Crawl-delay không?
Ví dụ:
User-agent: Googlebot Crawl-delay: 10Nha từng thấy dòng này trong rất nhiều file robots.txt.
Nhưng Google hiện nói:
Google không hỗ trợ crawl-delay trong robots.txt.
Google hỗ trợ các field chính:
user-agent;allow;disallow;sitemap.
Nếu server gặp vấn đề vì crawl, cách xử lý không nên chỉ là thêm:
Crawl-delay: 20rồi hy vọng Google nghe lời.
Sitemap có nên khai trong robots.txt không?
Có thể.
Ví dụ:
Sitemap: https://manhtunha.com/sitemap.xmlURL phải đầy đủ:
https://...Google cho phép khai nhiều sitemap.
Ví dụ:
Sitemap: https://example.com/sitemap-posts.xml Sitemap: https://example.com/sitemap-pages.xml Sitemap: https://example.com/sitemap-tags.xmlĐiều này nối trực tiếp với bài Sitemap XML Nha vừa viết.
robots.txt và Sitemap có chức năng ngược nhau không?
Không hẳn.
Sitemap nói:
Đây là những URL quan trọng mà tôi muốn crawler biết.
robots.txt nói:
Đây là những nơi crawler không nên truy cập.
Nhưng đừng tạo cấu hình kiểu:
Sitemap: https://example.com/private-page robots.txt: Disallow: /private-pageMột bên mời.
Một bên đóng cửa.
Không phải Google không xử lý được.
Nhưng website đang tự nói hai câu khác nhau.
robots.txt có nên chặn URL parameter không?
Có trường hợp phù hợp.
Ví dụ một e-commerce sinh ra hàng triệu URL:
?sort= ?filter= ?color= ?size= ?page= ?session=Faceted navigation có thể tạo ra một không gian URL rất lớn.
Ở những website như vậy, robots.txt có thể là một phần của chiến lược crawl management.
Nhưng với blog nhỏ, Nha không vội chặn hàng loạt parameter chỉ vì:
Parameter xấu cho SEO.
Cần biết URL đó dùng làm gì trước.
Có nên chặn Search Result nội bộ?
Thường có lý do để không muốn crawler đi sâu vào hàng nghìn URL kiểu:
/search?q=seo /search?q=ai /search?q=data ...Đặc biệt nếu query có thể tạo vô hạn.
Nhưng vẫn phải nhớ:
Chặn crawl không phải noindex.
Nếu Search Result đã được index trước đó và Nha muốn loại khỏi Google, cần xử lý indexing riêng.
Có nên chặn Admin bằng robots.txt?
Có thể chặn crawl để tránh crawler tốn request.
Ví dụ:
Disallow: /admin/Nhưng:
admin phải được bảo vệ bằng authentication.
Không phải bằng robots.txt.
Nếu `/admin/` mở công khai nhưng chỉ dựa vào:
Disallow: /admin/thì vấn đề không còn là SEO.
Có nên chặn CSS và JavaScript?
Nha thường tránh chặn các resource cần thiết để Google render nội dung.
Google Search hiện render JavaScript bằng Chromium.
Nếu CSS hoặc JS quan trọng bị robots.txt chặn, Google có thể không nhìn thấy trang giống người dùng.
Ví dụ trang chỉ hiển thị nội dung sau khi JavaScript chạy.
Nếu script đó không tải được với Googlebot thì việc:
Googlebot có crawl HTML
chưa chắc đã đủ.
robots.txt và JavaScript SEO
Năm 2026 Google tiếp tục làm rõ rằng JavaScript tự nó không phải vấn đề.
Google đã render JavaScript nhiều năm.
Điều đáng kiểm tra là:
- resource có crawl được không;
- API có hoạt động không;
- nội dung quan trọng có render không;
- canonical có nhất quán không;
- robots.txt có chặn resource quan trọng không.
JavaScript SEO xứng đáng một bài riêng.
Nha để dành.
robots.txt có giới hạn kích thước không?
Có.
Google hiện áp dụng giới hạn:
500 KiB.
Phần nội dung vượt quá giới hạn này có thể bị bỏ qua.
Nếu robots.txt dài tới mức 500 KiB thì Nha nghĩ vấn đề đã hơi khác.
Có thể website đang cố quản lý URL theo cách quá chi tiết bằng một file không sinh ra để làm việc đó.
Google cache robots.txt bao lâu?
Google thường cache robots.txt khoảng:
24 giờ.
Nhưng thời gian có thể dài hơn trong một số tình huống như:
- timeout;
- server error;
- không thể tải bản mới.
Vì vậy chỉnh robots.txt không nhất thiết có hiệu lực với mọi crawl request ngay trong vài giây.
Điều gì xảy ra nếu robots.txt trả 404?
Đây là phần khá thú vị.
Nếu robots.txt trả hầu hết lỗi 4xx như:
404 403Google thường xử lý như:
Không có robots.txt hợp lệ.
Tức là giả định:
Không có hạn chế crawling.
Riêng 429 được xử lý khác.
Đây cũng là lý do không nên dùng 403 cho robots.txt với suy nghĩ:
403 chắc Google sẽ không crawl site.
Điều gì xảy ra nếu robots.txt trả 5xx?
Phần này Google cập nhật khá rõ trong tài liệu hiện tại.
Nếu Google từng biết có robots.txt nhưng giờ không tải được vì 5xx:
Khoảng 12 giờ đầu
Google có thể tạm dừng crawl website trong khi tiếp tục thử tải robots.txt.
Sau đó
Nếu vẫn không tải được, Google có thể dùng bản robots.txt tốt gần nhất đã cache trong thời gian nhất định.
Google mô tả có thể sử dụng bản tốt cũ trong khoảng 30 ngày trong quá trình tiếp tục thử lại.
Điều này cho thấy:
robots.txt là một file nhỏ nhưng downtime của nó có thể ảnh hưởng crawling toàn site.
Đừng xem nó như file phụ không quan trọng.
Rule robots.txt có phân biệt chữ hoa chữ thường không?
Tên field như:
User-agent user-agent USER-AGENTkhông phải vấn đề lớn.
Nhưng path:
case-sensitive.
Ví dụ:
/Folder/và:
/folder/có thể là hai thứ khác nhau.
Đây là chi tiết đặc biệt đáng lưu ý trên hệ thống có URL case-sensitive.
Google có hỗ trợ Noindex trong robots.txt không?
Không nên dùng:
Noindex: /abc/trong robots.txt.
Google hiện chỉ tài liệu hóa những field chính như:
- User-agent;
- Allow;
- Disallow;
- Sitemap.
Muốn noindex:
dùng robots meta.
Đừng phát minh directive.
Một file robots.txt tốt có cần dài không?
Không.
Với blog cá nhân như manhtunha.com, nếu hệ thống URL sạch, Nha thích robots.txt càng dễ đọc càng tốt.
Ví dụ khung:
User-agent: *

# Chặn khu vực kỹ thuật nếu thật sự cần Disallow: /admin/

# Khai sitemap Sitemap: https://manhtunha.com/sitemap.xml
Đây chỉ là ví dụ.
Nha không khuyên copy nguyên file này vào production trước khi kiểm tra cấu trúc thật của website.
robots.txt phải được xây từ:
URL inventory thực tế.
Không phải template SEO trên mạng.
Đừng chặn Pagination chỉ vì không muốn nó Index
Ví dụ:
/online-marketing-p2.php /online-marketing-p3.phpNếu các trang pagination cần thiết để crawler đi tới những bài cũ thì chặn:
Disallow: /*-pmột cách máy móc có thể gây tác dụng ngược.
Nếu mục tiêu là kiểm soát index, phải xem:
- self-canonical;
- Internal Link;
- pagination architecture;
- Search Intent của trang archive.
Không phải cứ:
Không muốn rank → robots.txt.
Pagination là bài tiếp theo Nha sẽ viết riêng.
robots.txt và Crawl Budget
robots.txt có thể giúp giảm crawl ở những không gian URL vô hạn hoặc ít giá trị.
Ví dụ:
- faceted navigation;
- calendar vô hạn;
- sort/filter combinations;
- search result;
- proxy URL;
- session URL.
Nhưng với blog vài trăm hoặc vài nghìn URL, Nha không muốn:
Tối ưu crawl budget
trở thành lý do để viết một robots.txt dài 200 dòng.
Google nói crawl budget nâng cao chủ yếu đáng quan tâm với website rất lớn hoặc có vấn đề crawl rõ rệt.
robots.txt và AI Search năm 2026
Đây là phần mới khá đáng chú ý.
Google Search hiện có:
- AI Overviews;
- AI Mode;
- các tính năng generative AI khác.
Google nói những trang muốn đủ điều kiện xuất hiện như supporting link trong AI Overviews hoặc AI Mode vẫn cần:
- được crawl;
- được index;
- đủ điều kiện xuất hiện trên Search với snippet.
Nói cách khác:
Nếu robots.txt chặn Googlebot crawl một URL quan trọng, bạn đang chặn ngay từ tầng nền của Search.
Không có “GEO trick” nào sửa được điều đó.
Google-Extended có phải Googlebot không?
Không nên trộn hai thứ.
Googlebot liên quan trực tiếp tới crawling cho Google Search.
Google-Extended là một product token mà publisher có thể dùng để quản lý việc nội dung được sử dụng trong một số hệ thống Gemini và AI của Google.
Google nói rõ:
Google-Extended không ảnh hưởng việc website có được đưa vào Google Search hay không và không phải ranking signal của Search.
Ví dụ:
User-agent: Google-Extended Disallow: /không đồng nghĩa:
Chặn Google Search index website.
Cập nhật mới cuối 2026: AI training control trong robots.txt
Ngày 30/10/2026, Google thông báo kế hoạch hỗ trợ một tín hiệu chung trong robots.txt để website thể hiện preference về AI training với nhiều nhà cung cấp AI.
Đây là hướng phát triển từ nhóm AIPREF của IETF.
Nhưng có một điểm quan trọng:
Google dự kiến hỗ trợ cơ chế chung này trong năm 2027.
Vì vậy tại thời điểm Nha viết bài này tháng 11/2026:
đừng copy một directive AI-training mới rồi nghĩ Google đã hỗ trợ ngay.
Google-Extended vẫn là control riêng hiện có của Google.
Search generative AI control lại là chuyện khác
Google Search Console hiện đã có một control riêng cho website để quản lý việc nội dung có thể xuất hiện trong:
- AI Overviews;
- AI Mode;
- generative AI trong Discover.
Google cho biết control này đã rollout toàn cầu từ ngày 31/08/2026.
Đây là một điểm rất quan trọng.
Nó có nghĩa:
robots.txt ≠ Google-Extended ≠ Search generative AI controlBa thứ kiểm soát những lớp khác nhau.
Đừng gom chúng thành:
robots AI.
Vậy muốn xuất hiện trong AI Overviews thì robots.txt thế nào?
Google nói SEO nền tảng vẫn áp dụng.
Trang cần:
- cho phép Googlebot crawl;
- được index;
- đủ điều kiện hiển thị với snippet;
- và đáp ứng các yêu cầu Search thông thường.
Không cần:
- AI robots file riêng;
- Schema GEO;
- markup AI đặc biệt;
- hay một robots.txt riêng cho AI Overview.
Đây cũng phù hợp với điều Nha đã nói trong các bài về E-E-A-T, Entity và Topical Authority.
Nha sẽ audit robots.txt như thế nào?
Nha không nhìn file trước.
Nha nhìn mục tiêu trước.
1. URL nào thực sự không muốn crawler đi vào?
Liệt kê.
2. Tại sao?
Vì:
- bảo mật?
- crawl waste?
- duplicate?
- filter?
- không muốn index?
Nếu câu trả lời là:
Không muốn index
thì robots.txt có thể không phải đúng công cụ.
3. URL quan trọng có bị chặn nhầm không?
Đặc biệt:
- articles;
- categories;
- images;
- CSS;
- JavaScript;
- API cần render.
4. Sitemap có được khai đúng không?
URL đầy đủ.
5. Có directive Google không hỗ trợ không?
Ví dụ:
Crawl-delayhoặc:
Noindex:6. Có wildcard nguy hiểm không?
Kiểm tra bằng URL thật.
7. robots.txt có trả 200 không?
Đây là file cần ổn định.
8. Search Console có báo lỗi robots.txt không?
Kiểm tra.
Checklist robots.txt Nha sẽ dùng
- File có nằm đúng tại
/robots.txtkhông? - HTTP status có bình thường không?
- File có phải plain text UTF-8 không?
- Có vượt 500 KiB không?
- User-agent có đúng không?
- Disallow có chặn URL quan trọng không?
- Path có đúng chữ hoa/chữ thường không?
- Allow và Disallow có xung đột không?
- Wildcard có quá rộng không?
- Có dùng Crawl-delay với Googlebot không?
- Có dùng Noindex trong robots.txt không?
- Sitemap có URL tuyệt đối chưa?
- Có chặn CSS/JS cần cho render không?
- Có chặn trang nhưng đồng thời đặt noindex trong trang không?
- Có dùng robots.txt để “bảo vệ” dữ liệu riêng tư không?
- Subdomain có cần robots.txt riêng không?
- Có vô tình chặn toàn site bằng
Disallow: /không?
Ba cấu hình Nha đặc biệt sợ
1. Chặn toàn site ngoài ý muốn
User-agent: * Disallow: /Đôi khi cấu hình staging được copy sang production.
Thế là xong.
Website ra mắt.
Google đứng ngoài cửa.
2. Vừa Disallow vừa noindex
robots.txt: Disallow: /abc/HTML:
<meta name="robots" content="noindex">Google không crawl thì có thể không nhìn thấy noindex.
3. Chặn resource cần render
Disallow: /js/ Disallow: /css/trong khi trang phụ thuộc vào các resource này.
Đừng tối ưu crawler tới mức crawler không còn nhìn thấy trang.
Áp vào manhtunha.com thì sao?
Với manhtunha.com, Nha sẽ dùng robots.txt khá bảo thủ.
Đây là blog.
Không phải e-commerce có hàng triệu tổ hợp filter.
Nên mục tiêu không phải:
Chặn càng nhiều crawler càng tốt.
Mà là:
Đừng chặn nhầm những URL và resource cần thiết.
Nha sẽ ưu tiên:
- cho Google crawl bài viết;
- category quan trọng;
- tag đáng index;
- trang tác giả;
- ảnh đại diện;
- CSS/JS cần thiết;
- pagination cần cho discovery.
Còn:
- admin;
- URL hệ thống;
- search nội bộ;
- không gian URL vô hạn nếu có
mới là nhóm cần xem xét.
robots.txt và bài Indexing của Nha
Trong bài Indexing là gì? Vì sao Google đã crawl bài nhưng vẫn không lập chỉ mục?, Nha đã viết:
Crawl được không đồng nghĩa Index được.
robots.txt đứng trước đó một bước.
robots.txt ↓ Crawler được vào? ↓ Crawl ↓ Index ↓ Rank / ServeNếu ngay bước đầu đã:
Disallowthì những bước sau tất nhiên bị ảnh hưởng.
robots.txt và Canonical
Trong bài Canonical URL là gì? Vì sao Google chọn URL khác?, Nha đã nói Google cần crawl một trang để nhìn thấy canonical trong HTML.
Nếu duplicate URL bị robots.txt chặn:
Google có thể không đọc được:
<link rel="canonical" ...>trên chính URL đó.
Vì vậy:
Canonical hóa URL bằng cách chặn nó trong robots.txt không phải lúc nào cũng là chiến lược tốt.
robots.txt và Internal Link
Trong bài Internal Link là gì?, Nha xem link là đường đi của cả người dùng và crawler.
Nếu Internal Link dẫn tới URL bị Disallow:
website đang nói:
Trang này quan trọng đủ để tôi link.
robots.txt lại nói:
Nhưng đừng vào.
Có thể có lý do hợp lệ.
Nhưng ít nhất nên biết mình đang làm vậy.
Điều Nha thay đổi trong cách nhìn robots.txt
Ngày trước Nha nhìn robots.txt như một file SEO:
Chặn những thứ Google không nên index.
Bây giờ Nha sửa lại câu đó:
robots.txt là file quản lý crawling.
Muốn kiểm soát indexing:
noindex.
Muốn hợp nhất duplicate:
canonical hoặc redirect.
Muốn xóa URL cũ:
status code hoặc redirect phù hợp.
Muốn bảo vệ dữ liệu:
authentication.
Mỗi vấn đề có công cụ riêng.
Bạn nên mang gì về sau bài này?
- robots.txt chủ yếu kiểm soát crawling, không phải indexing.
- Một URL bị Disallow vẫn có khả năng xuất hiện trong Google Search nếu Google biết URL từ nguồn khác.
- Muốn loại trang khỏi Search, noindex thường phù hợp hơn.
- Muốn Google đọc noindex thì không nên chặn URL bằng robots.txt.
- robots.txt không phải công cụ bảo mật.
- File phải nằm ở root của từng host và rule chỉ áp dụng cho host/protocol/port đó.
- Google hỗ trợ User-agent, Allow, Disallow và Sitemap; không hỗ trợ crawl-delay.
- Path trong rule phân biệt chữ hoa chữ thường.
- Google thường cache robots.txt khoảng 24 giờ.
- Google giới hạn robots.txt ở 500 KiB.
- Đừng chặn CSS/JS cần để Google render trang.
- Google-Extended không phải Googlebot và không ảnh hưởng ranking Google Search.
- AI Search năm 2026 có thêm các control riêng, đừng gom tất cả vào robots.txt.
Nếu phải tóm cả bài bằng một câu, Nha sẽ chọn:
Đừng hỏi robots.txt có chặn Google hay không.
Hãy hỏi mình đang muốn chặn Google làm việc gì: crawl, index, hiển thị hay sử dụng dữ liệu.
Xác định đúng việc.
Rồi mới chọn đúng công cụ.
Một dòng Disallow đôi khi rất nhỏ.
Nhưng hậu quả của việc dùng sai nó thì không nhỏ chút nào.
Nguồn và tài liệu tham khảo
Nha ưu tiên tài liệu chính thức của Google và kiểm tra lại vào tháng 11/2026.
- Google Search Central - Introduction to robots.txt
Tài liệu nền tảng về mục đích của robots.txt. Google nói rõ robots.txt chủ yếu dùng để quản lý crawler traffic và không phải cơ chế để giữ một trang web khỏi Google Search. - Google - How Google interprets the robots.txt specification
Tài liệu kỹ thuật cập nhật trong năm 2026 về User-agent, Allow, Disallow, Sitemap, wildcard, ưu tiên rule, kích thước 500 KiB, cache robots.txt và cách Google xử lý lỗi HTTP. - Google Search Central - Block Search indexing with noindex
Google giải thích cách dùng meta robots hoặc X-Robots-Tag với noindex và nhấn mạnh URL không được robots.txt chặn nếu muốn Google đọc được noindex. - Google Search Central - Control the content you share with Google Search
Tài liệu tổng hợp các cơ chế kiểm soát crawl, index, snippet và nội dung được chia sẻ với Google Search. - Google Search Central - AI features and your website
Google xác nhận các nguyên tắc SEO nền tảng vẫn áp dụng cho AI Overviews và AI Mode; để đủ điều kiện xuất hiện, trang phải được crawl, index và đủ điều kiện hiển thị trong Search. - Google - Google's common crawlers
Tài liệu giải thích Googlebot, Google-Extended và các crawler/product token khác. Google nói rõ Google-Extended không ảnh hưởng việc website xuất hiện hay xếp hạng trong Google Search. - Google Search Central - Supporting a shared AI training control for websites
Thông báo ngày 30/10/2026 về kế hoạch hỗ trợ preference chung cho AI training trong robots.txt. Google dự kiến triển khai hỗ trợ cơ chế này từ năm 2027. - Google Search Console - Search generative AI control
Google cho biết control quản lý việc website tham gia AI Overviews, AI Mode và generative AI trong Discover đã được rollout toàn cầu từ ngày 31/08/2026.
Lưu ý: robots.txt là một phần của Robots Exclusion Protocol và chủ yếu kiểm soát crawling. Nó không phải công cụ bảo mật, không đảm bảo URL biến mất khỏi index và cũng không thay thế các cơ chế như noindex, canonical, redirect hoặc authentication.
Cảm ơn bạn đã đọc hết bài viết!
Bài viết sau
Giới thiệu
- Nguyễn Văn Nha
- Mãnh Tử Nha
- 11/07
- Developer - Blogger - Marketer
- Đồng Văn Cống, Thành phố Hồ Chí Minh
- Chat ngay
- 0393 314 999
- [email protected]
- Follow me on Facebook
- Follow me on twitter
- Mãnh Tử Nha Channel
- Follow me on Linkedin
- Follow me on Zalo
- Follow me on Tiktok
- Follow me on Strava
- www.manhtunha.com
- www.NHA.one
Tìm kiếm Google
Tài trợ
Bài viết mới nhất
 robots.txt là gì? Chặn Google crawl không có nghĩa là chặn Google index
 Sitemap XML là gì? Có Sitemap rồi tại sao Google vẫn không Index?
 Chạy bộ buổi sáng hay buổi chiều, lúc nào tốt hơn?
 7 lỗi trực quan hóa dữ liệu khiến biểu đồ gây hiểu nhầm
 Tương quan không có nghĩa là nguyên nhân: Vì sao hai con số cùng tăng chưa chắc liên quan đến nhau?
Có thể bạn thích
Xem nhiều nhất
 Bài học từ ba con chuột61.095 lượt xem
 Người chiến thắng59.008 lượt xem
 Bảng xếp hạng các Pokémon theo chỉ số CP56.851 lượt xem

 Bài học về sự tự cao55.468 lượt xem
Liên kết


