 English (EN)

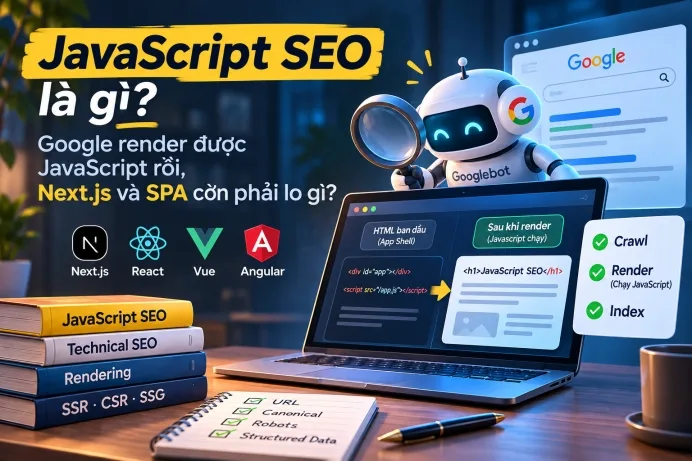
JavaScript SEO là gì? Google render được JavaScript rồi, Next.js và SPA còn phải lo gì?
Xem nhanh:
- JavaScript SEO là gì?
- Website HTML truyền thống và website JavaScript khác nhau ở đâu?
- Google xử lý JavaScript theo ba giai đoạn
- Bước 1: Crawling
- Bước 2: Rendering
- Bước 3: Indexing
- Google render được JavaScript thì tại sao vẫn cần JavaScript SEO?
- JavaScript không còn là kẻ thù của SEO
- SSR, CSR và SSG khác nhau thế nào?
- Google có thích SSR hơn CSR không?
- Với Next.js thì nên dùng cách nào?
- Thứ Nha quan tâm hơn framework: HTML ban đầu có gì?
- View Source và Inspect Element không giống nhau
- Nhưng Inspect Element vẫn chưa phải Google nhìn thấy gì
- Client-Side Routing là một điểm rất dễ sai
- Đừng dùng # làm route chính cho nội dung SEO
- Một URL phải hoạt động khi mở trực tiếp
- Internal Link bằng JavaScript có crawl được không?
- Framework Link component có sao không?
- Canonical và JavaScript: phần rất đáng chú ý
- Cách Nha làm Canonical với JavaScript
- Noindex và JavaScript còn dễ sai hơn
- Nhưng JavaScript có thể thêm noindex khi phát hiện lỗi
- SPA rất dễ tạo Soft 404
- Cách xử lý lỗi SPA
- HTTP Status Code vẫn rất quan trọng với website JavaScript
- Lazy Loading có làm Google không thấy nội dung không?
- Đừng bắt Google click “Xem thêm” để có content chính
- Infinite Scroll cũng là JavaScript SEO
- JavaScript gọi API nhưng API chặn Google thì sao?
- Đừng yêu cầu Googlebot cấp permission
- CSS và JavaScript đừng bị robots.txt chặn nhầm
- Structured Data có thể được JavaScript tạo không?
- Schema có cần nằm ngay HTML ban đầu không?
- Title và Meta Description có thể đổi bằng JavaScript không?
- H1 có cần nằm trong initial HTML không?
- Hydration là gì?
- Hydration Error có ảnh hưởng SEO không?
- Google index bản HTML hay bản Rendered?
- JavaScript có thể thay đổi nội dung sau khi Google render không?
- Dynamic Rendering còn nên dùng không?
- Tại sao Dynamic Rendering không phải lựa chọn đẹp?
- JavaScript Bundle càng lớn có càng xấu cho SEO?
- Googlebot cache JavaScript khá mạnh
- Web Components và Shadow DOM thì sao?
- JavaScript Error có thể làm mất cả Main Content
- Google Analytics không phải công cụ đo Googlebot đầy đủ
- JavaScript SEO và Crawl Budget liên quan thế nào?
- JavaScript SEO và AI Search
- Vậy Next.js có tốt cho SEO không?
- React có làm SEO kém không?
- Nha sẽ audit một website JavaScript theo thứ tự nào?
- 1. URL có request trực tiếp được không?
- 2. HTTP Status đúng chưa?
- 3. View Source có gì?
- 4. Rendered DOM có gì?
- 5. URL Inspection thấy gì?
- 6. JavaScript có lỗi không?
- 7. Resource có bị robots.txt chặn không?
- 8. Internal Link có href thật không?
- 9. Client-side routing có URL thật không?
- 10. Canonical có thay đổi sau render không?
- 11. Robots meta có thay đổi không?
- 12. Structured Data có còn tồn tại sau render không?
- 13. Lazy-loaded content có cần click hoặc scroll không?
- 14. Error route có Soft 404 không?
- 15. Performance có ổn không?
- Checklist JavaScript SEO Nha sẽ dùng
- Những điều Nha không làm chỉ vì nghe JavaScript SEO
- Áp vào các dự án của Nha thì sao?
- Một nguyên tắc rất developer mà Nha thấy hợp SEO
- JavaScript SEO không chỉ dành cho Google
- Vậy JavaScript có nên chỉ dùng cho tương tác?
- JavaScript SEO có phải tương lai của Technical SEO không?
- Bạn nên mang gì về sau bài này?
- Nguồn và tài liệu tham khảo
Có một câu về SEO mà Nha từng nghe rất nhiều:
Website dùng JavaScript thì Google không đọc được.
Ngày nay câu đó đã cũ.
Google Search có thể chạy JavaScript.
Googlebot sử dụng Web Rendering Service dựa trên Chromium để render trang.
Thậm chí tháng 3/2026, Google còn cập nhật tài liệu JavaScript SEO và bỏ một phần hướng dẫn cũ vì chính Google nói rằng Search đã render JavaScript trong nhiều năm; việc dùng JavaScript để tải nội dung không còn nên được diễn đạt đơn giản là:
Làm Google Search khó xử lý hơn.
Nghe tới đây rất dễ đi sang cực còn lại:
Google chạy được JavaScript rồi.
Frontend muốn làm gì cũng được.
Câu này cũng sai.
Google chạy JavaScript.
Nhưng website vẫn phải:
- crawl được;
- render được;
- trả nội dung đúng;
- có URL thật;
- có link crawlable;
- canonical nhất quán;
- status code đúng;
- và cuối cùng mới tới indexing.
Đây là lúc JavaScript SEO trở nên đáng học.
JavaScript SEO là gì?
JavaScript SEO là tập hợp các kỹ thuật giúp website sử dụng JavaScript vẫn có thể được công cụ tìm kiếm:
- khám phá;
- crawl;
- render;
- hiểu;
- và index nội dung đúng cách.
Nó không phải một nhánh SEO bí mật.
Cũng không có:
JavaScript SEO Score: 92/100Thực chất JavaScript SEO vẫn xoay quanh những nguyên tắc Technical SEO quen thuộc.
Chỉ thêm một tầng:
rendering.
Website HTML truyền thống và website JavaScript khác nhau ở đâu?
Với một trang server-rendered truyền thống, server có thể trả về:
<html> <head>

<title>JavaScript SEO là gì?</title> </head>

<body>

<h1>JavaScript SEO là gì?</h1>

<p>Đây là nội dung bài viết...</p>

<a href="/internal-link.php">

Internal Link

</a> </body> </html>
Googlebot tải HTML.
Nội dung đã ở đó.
Khá dễ.
Nhưng một ứng dụng client-side rendered có thể trả về ban đầu:
<html> <head></head>

<body>

<div id="app"></div>

<script src="/app.js"></script> </body> </html>
Nội dung thật chỉ xuất hiện sau khi:
app.js ↓ chạy ↓ gọi API ↓ nhận dữ liệu ↓ render DOMNgười dùng mở bằng Chrome vẫn thấy trang đẹp bình thường.
Nhưng crawler phải làm thêm việc.
Google xử lý JavaScript theo ba giai đoạn
Google hiện mô tả quá trình xử lý JavaScript web app qua ba bước lớn:
Crawling ↓ Rendering ↓ IndexingĐây là phần Nha muốn thêm vào chuỗi Technical SEO đang viết.
Ở những bài trước:
Discover ↓ Crawl ↓ IndexVới website JavaScript-heavy, nên nhìn chi tiết hơn:
Discover URL ↓ Crawl HTML ↓ Render JavaScript ↓ Tạo rendered DOM ↓ Phát hiện thêm link ↓ IndexBước 1: Crawling
Googlebot lấy URL từ crawl queue.
Server trả HTML.
Nếu nội dung chính đã nằm trong HTML thì Google có thể đọc khá nhiều thứ ngay lập tức.
Nếu HTML chỉ là app shell:
<div id="root"></div>Google cần render JavaScript để nhìn thấy phần còn lại.
Bước 2: Rendering
Google sử dụng Web Rendering Service với Chromium để chạy JavaScript.
Google hiện sử dụng một phiên bản Chromium hiện đại và cập nhật.
Sau khi JavaScript chạy, Google có thể nhìn thấy rendered HTML.
Ví dụ ban đầu:
<div id="root"></div>Sau render:
<div id="root">

<h1>JavaScript SEO là gì?</h1>

<p>Nội dung bài viết...</p> </div>
Google sử dụng phiên bản đã render để tiếp tục xử lý nội dung.
Bước 3: Indexing
Sau đó Google phân tích:
- text;
- title;
- heading;
- links;
- canonical;
- robots;
- structured data;
- hình ảnh;
- và nhiều tín hiệu khác.
Rồi mới quyết định:
Trang này có được index hay không?
Nha đã nói kỹ hơn về tầng này trong bài Indexing là gì? Vì sao Google đã crawl bài nhưng vẫn không lập chỉ mục?.
Google render được JavaScript thì tại sao vẫn cần JavaScript SEO?
Vì:
Có khả năng chạy JavaScript không đồng nghĩa mọi implementation JavaScript đều đúng.
Ví dụ JavaScript có thể:
- không tải được;
- bị robots.txt chặn;
- gọi API lỗi;
- timeout;
- phụ thuộc user interaction;
- tạo URL không crawlable;
- ghi canonical sai;
- tạo soft 404;
- hoặc render nội dung khác với HTML ban đầu.
Google chạy JavaScript.
Nhưng Google không sửa code cho mình.
JavaScript không còn là kẻ thù của SEO
Đây là một cập nhật tư duy Nha nghĩ nên nói thật rõ.
Google tháng 3/2026 đã sửa tài liệu để loại bỏ cách diễn đạt cũ khiến người đọc dễ hiểu rằng:
Dùng JavaScript để tải content làm Google Search khó xử lý.
Google đã render JavaScript nhiều năm.
Vậy nên:
JavaScript ≠ SEO xấuNhưng:
JavaScript render được ≠ mọi kiến trúc frontend đều tối ưuHai điều này cần đứng cùng nhau.
SSR, CSR và SSG khác nhau thế nào?
Nếu làm với Next.js hoặc các framework hiện đại, Nha thường gặp ba cách nhìn cơ bản.
CSR – Client-Side Rendering
Server trả app shell.
Browser chạy JavaScript rồi mới tạo nội dung.
Request ↓ HTML shell ↓ JavaScript ↓ API ↓ Render contentƯu điểm:
- trải nghiệm app mượt;
- frontend linh hoạt;
- navigation có thể rất nhanh.
Nhưng SEO cần kiểm tra kỹ hơn vì nội dung phụ thuộc rendering phía client.
SSR – Server-Side Rendering
Server tạo HTML có nội dung trước khi trả về.
Request ↓ Server lấy data ↓ Render HTML ↓ Browser nhận contentGooglebot có thể đọc nội dung ngay trong response HTML.
Static Rendering / Static Generation
HTML được tạo trước.
Khi request tới, server hoặc CDN chỉ cần trả file đã render.
Phù hợp với những nội dung không cần thay đổi theo từng request.
Google có thích SSR hơn CSR không?
Nha không dùng câu:
SSR là ranking factor.
Không có tài liệu Google nào nói vậy.
Google có thể xử lý client-side rendered content.
Nhưng Google vẫn nói server-side rendering hoặc pre-rendering là một ý tưởng tốt vì:
- nội dung có sẵn sớm hơn;
- nhanh hơn cho người dùng và crawler trong nhiều trường hợp;
- và không phải mọi bot trên Internet đều chạy JavaScript.
Vậy Nha nhìn SSR theo hướng:
Robustness.
Không phải:
Ranking hack.
Với Next.js thì nên dùng cách nào?
Nha không nghĩ mọi trang Next.js phải SSR.
Cũng không nghĩ mọi trang phải static.
Nên chọn theo bản chất dữ liệu.
Bài blog
Có thể render server hoặc static.
Nội dung chủ yếu giống nhau với mọi người.
Trang sản phẩm
Có thể server render hoặc static kết hợp cập nhật dữ liệu tùy hệ thống.
Dashboard sau đăng nhập
Có thể client-heavy.
SEO công khai thường không phải mục tiêu chính.
Search Result nội bộ
Cũng có thể client-side nhiều hơn tùy yêu cầu.
Không nên bắt một chiến lược render áp dụng cho mọi route chỉ vì:
SSR tốt cho SEO.
Thứ Nha quan tâm hơn framework: HTML ban đầu có gì?
Nha sẽ mở:
View Sourcevà hỏi:
Nếu JavaScript chưa chạy, Google nhận được gì?
Với trang SEO quan trọng, Nha thích những thứ này có sẵn sớm:
- title;
- meta description;
- canonical;
- robots;
- H1;
- main content;
- Internal Link quan trọng;
- structured data quan trọng.
Không phải vì Google không thể đọc chúng sau JavaScript.
Mà vì:
Nếu đã biết ngay từ đầu thì tại sao phải làm hệ thống phụ thuộc thêm một bước?
View Source và Inspect Element không giống nhau
Đây là một mẹo debug rất quan trọng.
View Source
Cho thấy HTML server gửi ban đầu.
Inspect Element
Cho thấy DOM sau khi browser:
- chạy JavaScript;
- thay đổi DOM;
- gọi API;
- render component.
Ví dụ View Source có:
<div id="app"></div>Inspect Element lại có:
<div id="app"> <h1>Hello Google</h1> </div>Khác biệt này chính là phần JavaScript đã tạo ra.
Nhưng Inspect Element vẫn chưa phải Google nhìn thấy gì
Đây là bước Nha không muốn bỏ.
Chrome của Nha và Web Rendering Service của Google không phải cùng một môi trường request.
Ví dụ:
- API có thể chặn Google;
- resource có thể bị robots.txt chặn;
- cookie khác;
- permission khác;
- geo khác;
- request có thể lỗi;
- JavaScript có exception chỉ xảy ra trong một số trường hợp.
Muốn biết Google nhìn thấy gì, dùng:
Google Search Console → URL Inspection → Test Live URLvà xem:
- rendered HTML;
- screenshot;
- loaded resources;
- JavaScript errors.
Google cũng khuyến nghị Rich Results Test cho một số trường hợp kiểm tra rendered content và structured data.
Client-Side Routing là một điểm rất dễ sai
SPA thường không reload cả trang khi chuyển route.
Ví dụ:
/products → /products/shoes → /products/shoes/redJavaScript đổi view.
Rất mượt.
Nhưng mỗi nội dung cần Search hiểu vẫn phải có:
URL thật.
Google hiện khuyến nghị với SPA sử dụng History API thay vì xây route nội dung dựa trên fragment.
Đừng dùng # làm route chính cho nội dung SEO
Ví dụ:
example.com/#/products example.com/#/serviceskhông phải pattern Nha muốn dùng cho các page cần index độc lập.
Nha thích:
example.com/products example.com/servicesvới History API để client-side navigation vẫn mượt.
URL đẹp không phải phần quan trọng nhất.
Quan trọng là:
Mỗi content state cần index phải có URL mà crawler có thể request trực tiếp.
Một URL phải hoạt động khi mở trực tiếp
Đây là lỗi SPA kinh điển.
Từ homepage bấm:
/products/shoesthì chạy tốt.
Nhưng copy URL đó sang tab mới:
404vì server không biết route.
Frontend biết.
Server không biết.
Với URL muốn index, đây là vấn đề.
Nha muốn:
Bất kỳ URL public quan trọng nào cũng phải request trực tiếp được.
Internal Link bằng JavaScript có crawl được không?
Có thể.
Nhưng cách an toàn rất quen:
<a href="/products/shoes"> Giày </a>Google nói link crawlable chủ yếu là:
<a href="...">Không nên chỉ có:
<span onclick="goTo('/products')"> Sản phẩm </span>hay:
<a onclick="goTo('/products')"> Sản phẩm </a>mà không có href.
Người dùng bấm được.
Crawler chưa chắc có đường rõ để đi.
Framework Link component có sao không?
Không quan trọng component tên gì.
Nha kiểm tra output cuối cùng.
Nếu browser DOM tạo ra:
<a href="/article"> ... </a>thì crawler có URL thực để xử lý.
Đừng đánh giá SEO bằng tên component.
Đánh giá HTML output.
Canonical và JavaScript: phần rất đáng chú ý
Google đã làm rõ vấn đề này từ cuối năm 2025 và tiếp tục giữ trong tài liệu JavaScript SEO hiện tại.
Canonicalization có thể được xử lý:
- trước rendering;
- và sau rendering.
Vì vậy nếu HTML ban đầu nói:
<link rel="canonical" href="https://example.com/a">nhưng JavaScript chạy xong đổi thành:
<link rel="canonical" href="https://example.com/b">website đang tự tạo hai tín hiệu.
Không nên.
Cách Nha làm Canonical với JavaScript
Tốt nhất:
Canonical đúng ngay trong HTML ban đầu.
Và JavaScript không thay đổi nó sang URL khác.
Nếu kiến trúc khiến canonical không thể có trong initial HTML thì Google cho phép JavaScript inject canonical.
Nhưng lúc đó:
Đừng để một canonical khác tồn tại sẵn trong HTML.
Một trang.
Một ý định canonical rõ.
Nha đã viết sâu hơn về chủ đề này trong bài Canonical URL là gì? Vì sao Google chọn URL khác?.
Noindex và JavaScript còn dễ sai hơn
Giả sử initial HTML có:
<meta name="robots" content="noindex">Sau đó JavaScript chạy và đổi thành:
indexhoặc xóa noindex.
Nha không dựa vào cách này.
Google hiện cảnh báo rằng khi thấy noindex, Google có thể bỏ qua rendering và JavaScript execution.
Nếu trang có khả năng cần được index:
Đừng đặt noindex trong HTML ban đầu rồi hy vọng JavaScript gỡ nó ra.
Đây là một lỗi logic rất dễ mắc trong SPA.
Nhưng JavaScript có thể thêm noindex khi phát hiện lỗi
Chiều ngược lại lại có trường hợp hợp lý.
Ví dụ URL sản phẩm trả app shell.
JavaScript gọi API và phát hiện:
Product does not existCó thể thêm:
<meta name="robots" content="noindex">để tránh error state đi vào index.
Tuy nhiên nếu có thể trả HTTP status đúng từ server thì Nha vẫn ưu tiên cách server hiểu trạng thái thật của URL.
SPA rất dễ tạo Soft 404
Ví dụ người dùng truy cập:
/product/khong-ton-taiServer trả:
200 OKJavaScript chạy rồi hiển thị:
Sản phẩm không tồn tại.
Về HTTP:
Trang thành công.
Về nội dung:
Trang lỗi.
Google có thể xem đây là:
soft 404.
Cách xử lý lỗi SPA
Google đưa ra hai hướng khi client-side routing khó trả status code đúng.
Cách tốt nếu kiến trúc cho phép
Chuyển tới một URL mà server thực sự trả:
404Hoặc
JavaScript thêm:
<meta name="robots" content="noindex">vào error state.
Nhưng nếu đang thiết kế hệ thống mới, Nha vẫn muốn xử lý status code đúng ở tầng server khi có thể.
HTTP Status Code vẫn rất quan trọng với website JavaScript
Framework hiện đại không làm HTTP biến mất.
Googlebot vẫn nhìn:
200 301 302 404 410 500 503Ví dụ:
Nội dung tồn tại
200Chuyển vĩnh viễn
301Không tồn tại
404 / 410Server lỗi
5xxĐừng để mọi route trong SPA trả:
200 OKchỉ vì frontend router xử lý tất cả.
Lazy Loading có làm Google không thấy nội dung không?
Có thể.
Lazy loading tự nó không xấu.
Thậm chí là kỹ thuật performance rất hữu ích.
Vấn đề nằm ở trigger.
Google nói content lazy-loaded nên được tải khi nó trở nên visible trong viewport mà không phụ thuộc vào một hành động của người dùng.
Ví dụ phù hợp:
- native lazy loading;
- IntersectionObserver;
- các kỹ thuật dựa trên viewport.
Đừng bắt Google click “Xem thêm” để có content chính
Ví dụ:
<button onclick="loadMore()"> Xem thêm </button>và phần lớn nội dung chỉ tải sau khi click.
Google không tương tác với trang như người dùng.
Google không ngồi click từng nút.
Tương tự:
Google không scroll như một người đang đọc Facebook.
Nếu content quan trọng cho indexing chỉ xuất hiện sau user interaction, Nha sẽ xem lại implementation.
Infinite Scroll cũng là JavaScript SEO
Nha vừa viết về chuyện này trong bài Pagination.
Người dùng có thể thích:
Scroll ↓ Load ↓ Scroll ↓ LoadNhưng crawler cần URL.
Nha thích mô hình:
UX: Infinite Scroll Underlying architecture: /page-2 /page-3 /page-4với crawlable links hoặc cơ chế tương ứng để Google khám phá từng phần nội dung.
JavaScript gọi API nhưng API chặn Google thì sao?
Trang HTML có thể crawl được.
JavaScript file có thể crawl được.
Nhưng content lại tới từ:
api.example.comNếu API:
- yêu cầu cookie đặc biệt;
- chặn bot;
- chặn IP;
- đòi permission;
- hay trả lỗi với Googlebot;
thì rendered page có thể trống.
Người dùng thấy đầy đủ.
Googlebot thấy cái vỏ.
Đây là lý do:
Chrome của tôi chạy được chưa đủ để kết luận Google render được.
Đừng yêu cầu Googlebot cấp permission
Ví dụ site cần:
- location permission;
- camera;
- notification;
- clipboard;
- một số browser permission khác;
để hiển thị nội dung chính.
Nha không thiết kế SEO content phụ thuộc vào việc crawler phải bấm:
Allow.
Googlebot có thể từ chối permission request.
Core content cần có fallback hợp lý.
CSS và JavaScript đừng bị robots.txt chặn nhầm
Trong bài robots.txt là gì?, Nha đã nói về chuyện này.
Ví dụ:
Disallow: /js/ Disallow: /css/nghe như tiết kiệm crawl.
Nhưng nếu Google cần những resource đó để render trang thì:
crawler tải HTML được.
Nhưng rendering lại lỗi.
Tối ưu quá tay.
Structured Data có thể được JavaScript tạo không?
Có.
Google nói JavaScript có thể tạo JSON-LD và inject vào trang.
Ví dụ app lấy dữ liệu sản phẩm từ API rồi tạo Product structured data.
Google có thể nhìn thấy structured data sau render.
Nhưng Nha vẫn giữ nguyên tắc:
Markup phải khớp nội dung người dùng thực sự thấy.
Và phải test rendered output.
Không phải JSON-LD nằm đâu đó trong JavaScript source là đủ.
Schema có cần nằm ngay HTML ban đầu không?
Không bắt buộc trong mọi trường hợp.
Google có thể xử lý structured data do JavaScript tạo.
Nhưng nếu đây là dữ liệu có sẵn ngay từ server và không thay đổi theo browser state, Nha vẫn thích xuất nó cùng HTML.
Ít dependency hơn.
Dễ debug hơn.
Nha đã nói kỹ hơn về nguyên tắc dùng Schema trong bài Schema là gì? Cách Nha dùng Structured Data đúng cách.
Title và Meta Description có thể đổi bằng JavaScript không?
Có.
Google có thể nhìn thấy title và meta description do JavaScript tạo.
Nhưng lại quay về câu hỏi:
Có cần phải đợi JavaScript mới biết title không?
Với route public quan trọng, Nha thích metadata đúng ngay khi response về.
Đặc biệt trên framework có khả năng tạo metadata server-side.
H1 có cần nằm trong initial HTML không?
Google có thể nhìn thấy H1 do JavaScript render.
Nhưng main content SEO của một trang public thường không có lý do mạnh để giấu hết phía sau client rendering nếu framework đã hỗ trợ server rendering.
Nha không tối ưu:
H1 phải nằm trong source vì Google không đọc JavaScript.
Nha tối ưu theo:
Core content càng ít dependency càng robust.
Hydration là gì?
Đây là một khái niệm hay gặp với framework hiện đại.
Server trả HTML đã có nội dung.
Sau đó JavaScript chạy ở browser để:
- gắn event;
- thêm state;
- biến HTML tĩnh thành giao diện tương tác.
Có thể hình dung:
Server HTML ↓ Người dùng đã thấy content ↓ JavaScript hydrate ↓ Trang trở nên interactiveĐây thường là một mô hình khá thân thiện với cả UX lẫn crawler khi triển khai tốt.
Hydration Error có ảnh hưởng SEO không?
Có thể.
Nếu server render một thứ nhưng client render một thứ khác, framework có thể gặp hydration mismatch.
Ví dụ server:
<h1>Tour Nhật Bản</h1>client lại tạo:
<h1>Tour Hàn Quốc</h1>Đây không chỉ là vấn đề console.
Nó cho thấy hai phiên bản nội dung không nhất quán.
Nha sẽ sửa logic dữ liệu trước khi nghĩ tới SEO.
Google index bản HTML hay bản Rendered?
Google sử dụng quá trình rendering để có nội dung JavaScript tạo ra.
Nhưng đây không có nghĩa initial HTML vô nghĩa.
Google có thể xử lý thông tin ở nhiều giai đoạn.
Canonical là ví dụ rất rõ:
Google có thể nhìn canonical trước và sau render.
Vì vậy nguyên tắc tốt là:
Đừng để hai giai đoạn nói hai câu khác nhau.
JavaScript có thể thay đổi nội dung sau khi Google render không?
Tất nhiên website có thể có dữ liệu realtime.
Nhưng Search không phải browser đang mở 24/7.
Google crawl tại một thời điểm.
Google render tại một thời điểm.
Rồi lưu thứ nó xử lý được.
Nếu content chỉ xuất hiện vài giây sau một chuỗi API dài hoặc phụ thuộc state phức tạp, Nha sẽ không xem đó là kiến trúc lý tưởng cho content cần Search hiểu.
Dynamic Rendering còn nên dùng không?
Ngày trước có một giải pháp khá nổi tiếng:
Dynamic Rendering.
Ý tưởng:
User → JavaScript version Bot → Pre-rendered HTML versionNó từng được sử dụng như workaround khi crawler gặp khó với JavaScript.
Nhưng tài liệu Google hiện tại nói khá rõ:
Dynamic rendering là workaround cũ và không phải giải pháp dài hạn được khuyến nghị.
Google khuyến nghị thay vào đó cân nhắc:
- server-side rendering;
- static rendering;
- hydration.
Nếu hệ thống cũ đang dynamic render và hoạt động, không có nghĩa phải phá ngay.
Nhưng với dự án mới, Nha không chọn dynamic rendering như kiến trúc SEO mặc định.
Tại sao Dynamic Rendering không phải lựa chọn đẹp?
Vì phải duy trì hai phiên bản:
Bot version User versionHai pipeline.
Hai khả năng lỗi.
Hai phiên bản có thể lệch nhau.
Và thêm chi phí hạ tầng.
Nha thích:
Một kiến trúc tốt cho cả người dùng lẫn crawler.
hơn là:
Một website cho người và một website cho bot.
JavaScript Bundle càng lớn có càng xấu cho SEO?
Không có con số:
Bundle > 500 KB → Google không rankNhưng JavaScript nặng có thể ảnh hưởng:
- performance;
- latency;
- Core Web Vitals;
- rendering;
- thiết bị yếu;
- trải nghiệm người dùng.
Vì vậy giảm JavaScript không cần thiết vẫn là việc đáng làm.
Không phải vì Google ghét file JS.
Mà vì browser và người dùng phải chạy nó.
Googlebot cache JavaScript khá mạnh
Google nói Googlebot có thể cache resource mạnh để giảm request và tài nguyên.
Điều này dẫn tới một chi tiết kỹ thuật rất hay.
Nếu file:
main.jsthay đổi nội dung nhưng URL vẫn giữ nguyên, cache có thể tạo tình huống phiên bản cũ được sử dụng ở một số thời điểm.
Mô hình tốt hơn là:
main.a83d92.js main.b74cd1.jsTức là:
content fingerprinting.
Mỗi lần build thay đổi nội dung thì filename đổi.
CDN thích.
Browser thích.
Crawler cũng đỡ mơ hồ hơn về version.
Web Components và Shadow DOM thì sao?
Google hỗ trợ Web Components.
Khi render, Google có thể flatten Shadow DOM và Light DOM để xử lý nội dung nhìn thấy trong rendered HTML.
Nhưng Nha vẫn sẽ test:
URL Inspection Rich Results Testđể chắc rằng nội dung thực sự xuất hiện trong rendered DOM.
Đừng dựa vào:
Theo lý thuyết Google hỗ trợ.
Trong kỹ thuật:
test vẫn rẻ hơn đoán.
JavaScript Error có thể làm mất cả Main Content
Ví dụ:
bundle.js ↓ Uncaught TypeError ↓ app crash ↓ main content không renderServer vẫn trả:
200 OKNhưng rendered page gần như trắng.
Đây có thể trở thành:
- indexing issue;
- soft 404;
- quality issue;
- UX issue.
Với JavaScript site, console error không chỉ là chuyện dev.
Nó có thể trở thành Search issue.
Google Analytics không phải công cụ đo Googlebot đầy đủ
Đây cũng là một điểm Nha thấy thú vị.
Client-side analytics không phản ánh chính xác toàn bộ hoạt động của Googlebot hoặc Web Rendering Service.
Google có thể:
- không chạy analytics request;
- bỏ resource không cần thiết cho main content;
- hoặc xử lý theo cách khác browser người dùng.
Muốn xem crawl:
Nha dùng:
Search Console Crawl Statsvà nếu cần sâu hơn:
server access logKhông nhìn GA4 rồi kết luận:
Googlebot chưa vào.
JavaScript SEO và Crawl Budget liên quan thế nào?
Nha vừa viết bài Crawl Budget là gì? Blog vài nghìn URL có thật sự cần tối ưu không?.
JavaScript resource cũng cần crawl.
Rendering cũng cần tài nguyên.
Nhưng với website nhỏ, Nha vẫn không dùng lý do:
Tiết kiệm Crawl Budget.
để chặn toàn bộ CSS và JS.
Nếu resource cần cho rendering, việc chặn nó có thể khiến Google hiểu trang kém hơn.
JavaScript SEO và AI Search
Google trong hướng dẫn generative AI Search năm 2026 vẫn nhắc:
Nếu sử dụng JavaScript, hãy tuân thủ JavaScript SEO best practices.
Google có thể xử lý nội dung trong JavaScript miễn là nội dung không bị chặn.
Nhưng Google cũng nói làm SEO với website sử dụng JavaScript framework nhìn chung phức tạp hơn những website đơn giản hơn.
Điều đó khá hợp lý.
AEO.
GEO.
AI Mode.
Tất cả vẫn đứng phía sau:
URL ↓ Crawl ↓ Render ↓ Index ↓ Understand ↓ RetrieveNếu rendered HTML trống thì chưa cần bàn prompt-friendly content.
Vậy Next.js có tốt cho SEO không?
Nha sẽ trả lời:
Next.js có khả năng xây website rất tốt cho SEO.
Nhưng Next.js không tự động làm SEO thay cho developer.
Developer vẫn có thể tạo:
- canonical sai;
- duplicate URL;
- link không crawlable;
- metadata sai;
- soft 404;
- client-side route lỗi;
- content chỉ xuất hiện sau user interaction.
Framework mạnh.
Implementation vẫn quyết định.
React có làm SEO kém không?
Không.
Vue.
React.
Angular.
Next.js.
Nuxt.
Svelte.
Framework không phải ranking factor.
Nha không hỏi:
Framework nào Google thích?
Nha hỏi:
Output cuối cùng Google nhận được có đúng không?
Nha sẽ audit một website JavaScript theo thứ tự nào?
1. URL có request trực tiếp được không?
Copy URL.
Mở tab mới.
Không đi qua homepage.
Nó có hoạt động không?
2. HTTP Status đúng chưa?
Trang có:
200không?
Trang lỗi có thật sự:
404không?
3. View Source có gì?
Kiểm tra:
- title;
- description;
- canonical;
- robots;
- H1;
- main content;
- links;
- structured data.
4. Rendered DOM có gì?
So với initial HTML.
5. URL Inspection thấy gì?
Đây mới là góc nhìn gần Google nhất trong bộ công cụ thường ngày.
6. JavaScript có lỗi không?
Console.
Network.
API.
7. Resource có bị robots.txt chặn không?
Đặc biệt:
- JS;
- CSS;
- API cần cho content.
8. Internal Link có href thật không?
Không chỉ onclick.
9. Client-side routing có URL thật không?
Không chỉ hash route.
10. Canonical có thay đổi sau render không?
So source và rendered DOM.
11. Robots meta có thay đổi không?
Đặc biệt tránh initial:
noindexrồi JavaScript gỡ.
12. Structured Data có còn tồn tại sau render không?
Test.
13. Lazy-loaded content có cần click hoặc scroll không?
Nếu có thì xem lại.
14. Error route có Soft 404 không?
Rất quan trọng với SPA.
15. Performance có ổn không?
JavaScript quá nặng có thể ảnh hưởng UX và rendering.
Checklist JavaScript SEO Nha sẽ dùng
- URL public có hoạt động khi request trực tiếp không?
- Server có trả HTTP status đúng không?
- Core content có xuất hiện trong rendered HTML không?
- Title có đúng không?
- Meta description có đúng không?
- Canonical có đúng và duy nhất không?
- Canonical trước và sau render có giống nhau không?
- Robots meta có đúng không?
- Có initial noindex rồi gỡ bằng JavaScript không?
- H1 và main content có render ổn định không?
- Internal Link có dùng thẻ a với href không?
- Route có dùng URL thực hay chỉ fragment?
- Trang lỗi có trả 404 hoặc noindex đúng không?
- Có soft 404 không?
- API cần cho main content có hoạt động với crawler không?
- CSS/JS có bị robots.txt chặn không?
- Lazy loading có phụ thuộc user interaction không?
- Infinite Scroll có paginated URLs không?
- Structured Data có xuất hiện trong rendered HTML không?
- JavaScript console có error không?
- Bundle có quá nặng không?
- Static assets có content fingerprint không?
- URL Inspection có thấy cùng nội dung như người dùng không?
Những điều Nha không làm chỉ vì nghe JavaScript SEO
- Không bỏ React hoặc Next.js chỉ vì sợ Google không đọc JavaScript.
- Không chuyển toàn bộ website sang SSR nếu không có lý do.
- Không coi SSR là ranking factor.
- Không dùng Dynamic Rendering làm kiến trúc mặc định cho dự án mới.
- Không tạo route bằng hash cho những nội dung cần index riêng.
- Không dùng onclick thay cho href ở link quan trọng.
- Không để mọi route lỗi trả 200.
- Không đặt noindex ban đầu rồi dùng JavaScript để gỡ.
- Không để JavaScript đổi canonical sang URL khác.
- Không chặn CSS và JS cần cho rendering.
- Không bắt Google click nút để tải main content.
- Không nhìn Chrome của mình rồi kết luận Googlebot chắc chắn nhìn giống vậy.
Áp vào các dự án của Nha thì sao?
Với blog manhtunha.com hiện tại, phần lớn nội dung vẫn được server trả khá trực tiếp.
JavaScript SEO chưa phải vấn đề lớn nhất.
Nhưng với những dự án Nha làm bằng framework hiện đại như Next.js, checklist này quan trọng hơn nhiều.
Nha sẽ ưu tiên cho các route public cần SEO:
URL thật ↓ HTTP status đúng ↓ Metadata đúng ↓ HTML có core content ↓ Internal Link crawlable ↓ Canonical đúng ↓ Hydration ↓ Interactive featuresThay vì:
HTML shell ↓ 10 JS bundles ↓ 3 API calls ↓ permission ↓ client state ↓ hy vọng Google thấy contentCách thứ hai vẫn có thể hoạt động.
Nhưng Nha không tự tạo thêm dependency nếu không cần thiết.
Một nguyên tắc rất developer mà Nha thấy hợp SEO
Càng nhiều dependency, càng nhiều điểm có thể lỗi.
Nếu một trang muốn hiển thị H1 phải phụ thuộc:
JavaScript + API + cookie + state + permission + client routethì khả năng một thứ trong chuỗi hỏng sẽ cao hơn:
H1 có ngay trong HTMLĐó không phải triết lý:
HTML cổ điển tốt, JavaScript hiện đại xấu.
Mà là:
Đừng dùng một hệ thống phức tạp hơn mức bài toán cần.
JavaScript SEO không chỉ dành cho Google
Google chạy JavaScript khá tốt.
Nhưng không phải:
- mọi search engine;
- mọi crawler;
- mọi social bot;
- mọi AI crawler
đều có cùng khả năng rendering.
Đây là một lý do nữa Nha thích core content xuất hiện sớm trong HTML nếu có thể.
Nó tạo ra một web dễ đọc hơn cho nhiều loại client.
Vậy JavaScript có nên chỉ dùng cho tương tác?
Không nhất thiết.
Website hiện đại có thể dùng JavaScript cho:
- data fetching;
- render content;
- routing;
- UI;
- state;
- animation;
- commerce;
- booking.
Nha không đặt ranh giới:
Content = HTML.
Interaction = JavaScript.
Ranh giới Nha quan tâm là:
Nội dung quan trọng có thể được crawler truy cập và render ổn định hay không?
JavaScript SEO có phải tương lai của Technical SEO không?
Nha nghĩ nó đã là hiện tại từ lâu rồi.
Frontend ngày càng giống application.
Website:
- render server;
- hydrate client;
- fetch API;
- stream content;
- cache CDN;
- navigate không reload.
Technical SEO vì vậy không thể chỉ còn:
title meta keywords sitemap.xmlNgười làm SEO kỹ thuật ngày càng phải hiểu:
- HTTP;
- rendering;
- DOM;
- JavaScript;
- routing;
- API;
- caching;
- server;
- browser.
Đây cũng là phần Nha thấy khá thú vị.
SEO và lập trình ngày càng nói chuyện với nhau nhiều hơn.
Bạn nên mang gì về sau bài này?
- Google có thể chạy JavaScript bằng Chromium và đã làm việc này trong nhiều năm.
- JavaScript tự nó không phải vấn đề SEO.
- Google xử lý JavaScript qua Crawl → Render → Index.
- Server-side rendering không phải ranking factor, nhưng có thể làm website robust hơn cho người dùng và crawler.
- URL public cần hoạt động khi request trực tiếp, không chỉ khi điều hướng từ SPA.
- Internal Link quan trọng nên tạo ra thẻ a có href thực.
- Client-side routing nên sử dụng URL thật; không nên dùng hash route cho content cần index riêng.
- Canonical trước và sau JavaScript render không nên mâu thuẫn.
- Không nên đặt noindex trong initial HTML rồi dùng JavaScript để gỡ nếu muốn trang được index.
- SPA phải cẩn thận với soft 404.
- Lazy-loaded content quan trọng không nên phụ thuộc vào click hoặc scroll của người dùng.
- Dynamic Rendering hiện được Google xem là workaround cũ, không phải giải pháp dài hạn.
- Structured Data có thể được tạo bằng JavaScript nhưng vẫn phải test rendered output.
- Google render được trang không có nghĩa mọi crawler khác cũng render được.
Nếu phải giữ một câu sau bài này, Nha sẽ chọn:
Đừng hỏi Google có chạy được JavaScript không.
Hãy hỏi sau khi JavaScript chạy, Google thực sự nhận được thứ gì.
Đó mới là câu hỏi kỹ thuật.
Và cũng là lý do Nha không còn sợ JavaScript trong SEO.
Nha chỉ sợ...
JavaScript viết sai.
Nguồn và tài liệu tham khảo
Nha ưu tiên nguồn chính thức của Google và kiểm tra lại vào tháng 11/2026.
- Google Search Central - Understand JavaScript SEO basics
Nguồn chính của bài. Google mô tả quá trình Crawling → Rendering → Indexing, cách xử lý client-side rendered content, canonical, robots meta, client-side routing, structured data, caching và Web Components. - Google Search Central - Fix Search-related JavaScript problems
Hướng dẫn debug JavaScript bằng URL Inspection, rendered HTML, console errors, resource loading và cách xử lý soft 404 trong SPA. - Google Search Central - Fix lazy-loaded content
Google hướng dẫn lazy-load nội dung dựa trên viewport và lưu ý không nên phụ thuộc vào hành động như click hoặc scroll để tải nội dung cần Google nhìn thấy. - Google Search Central - Dynamic rendering as a workaround
Google hiện xem Dynamic Rendering là workaround cũ, không phải giải pháp dài hạn, và khuyến nghị server-side rendering, static rendering hoặc hydration. - Google Search Central - Link best practices
Google hướng dẫn link crawlable bằng thẻ a có href và giải thích những dạng JavaScript link crawler không thể dựa vào một cách ổn định. - Google Search Central - Canonicalization
Tài liệu làm rõ canonical với client-side rendering: Google khuyến nghị canonical trong source HTML và JavaScript không thay đổi nó sang URL khác. - Google Search Central - How Google Search Works
Tài liệu tổng quan về crawling, rendering, indexing và cách Google chạy JavaScript bằng phiên bản Chrome hiện đại trong quá trình xử lý trang. - Google Search Central - Search documentation updates
Changelog chính thức. Tháng 02/2026 Google rà soát và cập nhật bộ tài liệu JavaScript SEO; tháng 03/2026 Google loại bỏ phần hướng dẫn lỗi thời và làm rõ rằng Search đã render JavaScript trong nhiều năm. - Google Search Central - Optimizing for generative AI features
Google tiếp tục khuyến nghị website sử dụng JavaScript tuân thủ JavaScript SEO best practices khi muốn tối ưu khả năng xuất hiện trong Search và các trải nghiệm generative AI.
Lưu ý: JavaScript, React, Next.js hay các framework frontend không phải ranking factor. Điều quan trọng với Search là URL, khả năng crawl và render, HTTP status, metadata, nội dung, link và những tín hiệu cuối cùng mà Google thực sự nhận được.
Cảm ơn bạn đã đọc hết bài viết!
Bài viết sau
Giới thiệu
- Nguyễn Văn Nha
- Mãnh Tử Nha
- 11/07
- Developer - Blogger - Marketer
- Đồng Văn Cống, Thành phố Hồ Chí Minh
- Chat ngay
- 0393 314 999
- [email protected]
- Follow me on Facebook
- Follow me on twitter
- Mãnh Tử Nha Channel
- Follow me on Linkedin
- Follow me on Zalo
- Follow me on Tiktok
- Follow me on Strava
- www.manhtunha.com
- www.NHA.one
Tìm kiếm Google
Bài viết mới nhất
 20 câu đố vui có đáp án bất ngờ, hỏi xong ai cũng muốn hỏi lại
 JavaScript SEO là gì? Google render được JavaScript rồi, Next.js và SPA còn phải lo gì?
 Chạy bộ hãy lắng nghe cơ thể, đừng chỉ nhìn đồng hồ
 Feature Flags là gì? Cách bật tính năng mới mà không phải Go-live cho tất cả
 Chạy bao nhiêu kilomet mỗi tuần là phù hợp? Đừng chỉ nhìn tổng quãng đường
Có thể bạn thích
Xem nhiều nhất
 Bài học từ ba con chuột61.138 lượt xem
 Người chiến thắng59.049 lượt xem
 Bảng xếp hạng các Pokémon theo chỉ số CP56.895 lượt xem

 Bài học về sự tự cao55.507 lượt xem
Liên kết


