English (EN)

Lấy mẫu dữ liệu là gì? Cách chọn mẫu để phân tích không bị lệch
Lấy mẫu dữ liệu là quá trình lựa chọn một phần các quan sát từ một tổng thể để thu thập hoặc phân tích thay vì xử lý toàn bộ tổng thể.
Ví dụ:
Một công ty có 500.000 khách hàng.
Mình muốn biết mức độ hài lòng của khách hàng.
Không nhất thiết phải hỏi cả 500.000 người.
Mình có thể chọn một sample rồi dùng dữ liệu từ sample đó để ước lượng hoặc tìm hiểu đặc điểm của population.
Nhưng:
Lấy ít dữ liệu không phải phần khó nhất.
Khó nhất là lấy đúng dữ liệu.
Population và Sample
Hai khái niệm đầu tiên cần phân biệt là:
| Khái niệm | Ý nghĩa |
|---|---|
| Population | Toàn bộ nhóm đối tượng hoặc quan sát mà mình muốn tìm hiểu |
| Sample | Một phần được chọn từ population để thu thập hoặc phân tích dữ liệu |
Ví dụ muốn nghiên cứu hành vi của tất cả khách hàng đã mua hàng trong năm:
Population = toàn bộ khách hàng đã mua.
Sample = nhóm khách hàng được chọn để phân tích hoặc khảo sát.
Tại sao phải lấy mẫu?
Phân tích toàn bộ population không phải lúc nào cũng khả thi.
Lý do có thể là:
- quá nhiều dữ liệu;
- chi phí thu thập cao;
- thời gian hạn chế;
- không thể tiếp cận toàn bộ đối tượng;
- phép đo có tính phá hủy;
- cần ra quyết định nhanh.
Lấy mẫu giúp giảm chi phí và khối lượng công việc.
Nhưng đổi lại:
Mình phải chấp nhận uncertainty.
Sample tốt là sample như thế nào?
Một sample tốt không đơn giản là sample lớn.
Nó cần phù hợp với câu hỏi đang nghiên cứu.
Cần xem:
- population được định nghĩa thế nào;
- ai có cơ hội được chọn;
- cơ chế chọn mẫu;
- nhóm nào đang bị bỏ sót;
- sample size;
- nonresponse;
- sampling bias;
- mục tiêu suy luận.
Representativeness không tự xuất hiện chỉ vì dataset có nhiều dòng.
Sampling Frame là gì?
Sampling Frame là tập danh sách hoặc nguồn mà mình thực tế sử dụng để chọn sample.
Population và Sampling Frame có thể không giống nhau.
Ví dụ muốn khảo sát:
Tất cả khách hàng.
Nhưng danh sách mình có chỉ gồm:
Khách hàng có email hợp lệ.
Như vậy một số nhóm đã không có cơ hội được chọn.
Đây có thể tạo ra coverage bias.
Random Sampling là gì?
Simple Random Sampling là phương pháp trong đó các đơn vị trong population có cơ chế ngẫu nhiên để được chọn vào sample.
Ví dụ có 10.000 khách hàng và cần chọn 1.000 người.
Mình có thể gán ID rồi dùng một phương pháp random để chọn 1.000 ID.
Điểm quan trọng không phải chữ:
random.
Mà là:
cơ chế chọn mẫu không phụ thuộc tùy tiện vào người thực hiện.
Random không có nghĩa sample chắc chắn giống population hoàn hảo
Một sample ngẫu nhiên vẫn có thể tình cờ:
- nhiều nam hơn nữ;
- nhiều khách hàng ở một khu vực;
- nhiều người dùng một nhóm sản phẩm.
Random Sampling giúp kiểm soát cơ chế lựa chọn.
Nó không đảm bảo sample nhỏ sẽ phản ánh population chính xác từng tỷ lệ.
Stratified Sampling là gì?
Stratified Sampling chia population thành các nhóm có ý nghĩa trước khi lấy mẫu.
Ví dụ chia khách hàng theo:
- khu vực;
- độ tuổi;
- loại sản phẩm;
- phân khúc khách hàng.
Sau đó lấy sample trong từng nhóm.
Phương pháp này hữu ích khi mình muốn đảm bảo các subgroup quan trọng được đại diện đủ trong sample.
Ví dụ về Stratified Sampling
Population có:
- 70% khách hàng miền Nam;
- 20% miền Bắc;
- 10% miền Trung.
Nếu lấy sample 1.000 người theo tỷ lệ population thì có thể chọn khoảng:
- 700 miền Nam;
- 200 miền Bắc;
- 100 miền Trung.
Đó là một dạng proportionate stratified sampling.
Nhưng đôi khi nhóm nhỏ lại rất quan trọng.
Khi đó mình có thể oversample nhóm đó rồi dùng weighting phù hợp trong phân tích.
Systematic Sampling là gì?
Systematic Sampling chọn quan sát theo một khoảng cách đều sau khi xác định điểm bắt đầu phù hợp.
Ví dụ:
Có danh sách 10.000 khách hàng.
Cần khoảng 1.000 người.
Có thể lấy khoảng mỗi 10 người một người sau một điểm bắt đầu ngẫu nhiên.
Cách này dễ triển khai.
Nhưng cần cẩn thận nếu thứ tự dữ liệu chứa một pattern có chu kỳ liên quan tới khoảng lấy mẫu.
Cluster Sampling là gì?
Cluster Sampling chia population thành các cụm tự nhiên rồi chọn một số cluster để nghiên cứu.
Ví dụ nghiên cứu học sinh trên toàn quốc.
Thay vì chọn từng học sinh ngẫu nhiên trên toàn quốc, có thể:
- chọn một số trường;
- sau đó khảo sát học sinh trong những trường được chọn.
Cách này có thể giảm đáng kể chi phí thu thập dữ liệu.
Nhưng các quan sát trong cùng cluster thường giống nhau hơn so với các quan sát hoàn toàn ngẫu nhiên.
Điều đó ảnh hưởng tới variance và cách tính uncertainty.
Convenience Sampling
Convenience Sampling lấy những đối tượng dễ tiếp cận nhất.
Ví dụ đăng một khảo sát lên Facebook cá nhân rồi hỏi:
Người Việt Nam nghĩ gì về AI?
Sample thực tế có thể chủ yếu là:
- bạn bè;
- người làm công nghệ;
- người đang dùng Facebook;
- những người quan tâm đủ để trả lời.
Nó có thể cho insight.
Nhưng không nên vội suy luận:
Đây là quan điểm của toàn bộ người Việt Nam.
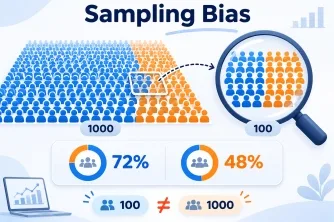
Sampling Bias là gì?
Sampling Bias xảy ra khi cơ chế chọn mẫu làm một số nhóm có khả năng xuất hiện trong sample nhiều hoặc ít hơn theo cách có hệ thống.
Ví dụ muốn biết mức độ hài lòng của tất cả khách hàng nhưng chỉ khảo sát:
những người đang theo dõi fanpage.
Nhóm này có thể khác đáng kể với:
- khách không dùng Facebook;
- khách không còn theo dõi thương hiệu;
- khách chỉ mua một lần;
- khách đang không hài lòng.
Bias đến từ cách dữ liệu được tạo ra trước khi mình bắt đầu tính toán.
Selection Bias rộng hơn Sampling Bias
Hai thuật ngữ có liên quan nhưng không nên luôn coi là một.
Sampling Bias tập trung vào vấn đề trong cách sample được chọn.
Selection Bias rộng hơn, nói về những cơ chế lựa chọn khiến nhóm được quan sát khác có hệ thống so với nhóm cần suy luận.
Ví dụ:
- self-selection;
- survivorship;
- nonresponse;
- eligibility criteria không phù hợp.
Self-selection Bias
Khảo sát mở thường gặp vấn đề này.
Những người quyết định tham gia có thể khác những người không tham gia.
Ví dụ câu hỏi:
Bạn có hài lòng với dịch vụ không?
Những người cực kỳ hài lòng hoặc cực kỳ không hài lòng có thể có động lực trả lời cao hơn nhóm trung tính.
Kết quả không chỉ phụ thuộc câu hỏi.
Nó còn phụ thuộc:
Ai quyết định trả lời.
Nonresponse Bias
Mình có thể chọn sample rất tốt nhưng vẫn gặp vấn đề nếu nhiều người không trả lời.
Nếu nonresponse xảy ra ngẫu nhiên thì ảnh hưởng có thể khác.
Nhưng nếu nhóm không trả lời có đặc điểm hệ thống khác nhóm trả lời thì kết quả có thể bị bias.
Ví dụ:
Khách hàng không hài lòng ít muốn tương tác với thương hiệu.
Khảo sát satisfaction chỉ dựa trên người phản hồi có thể đánh giá quá cao mức hài lòng.
Sample Size là gì?
Sample Size là số quan sát trong sample.
Sample lớn hơn thường giúp giảm sampling variability trong nhiều bài toán.
Nhưng:
Sample lớn không sửa được một cơ chế lấy mẫu sai.
Nếu sample bias thì:
1.000 quan sát bị bias.
10.000 quan sát bị bias.
1.000.000 quan sát bị bias.
vẫn có thể dẫn mình tới kết luận sai.
Big Data không loại bỏ Sampling Bias
Đây là một hiểu lầm rất dễ gặp.
Một dataset có hàng triệu record nghe rất thuyết phục.
Nhưng cần hỏi:
- những record này đến từ đâu;
- ai không có trong dataset;
- hành vi nào không được ghi nhận;
- dữ liệu được tạo qua cơ chế nào;
- population mình muốn suy luận là gì.
Big Data vẫn có thể là một sample rất lệch của thế giới thật.
Sampling Error là gì?
Nếu mình lấy hai random sample khác nhau từ cùng một population, kết quả thống kê thường không giống hệt nhau.
Sự khác biệt do sample chỉ là một phần của population được gọi là sampling variability và thường được mô tả thông qua sampling error hoặc uncertainty.
Đây là điều tự nhiên của sampling.
Không phải bug.
Sampling Error khác Bias
| Vấn đề | Bản chất |
|---|---|
| Sampling Error | Biến thiên do chỉ quan sát một sample thay vì toàn population |
| Sampling Bias | Sai lệch có hệ thống do cơ chế chọn sample |
Tăng sample size có thể giảm sampling error.
Nhưng:
Tăng sample size không tự động loại bỏ sampling bias.
Margin of Error
Trong khảo sát, mình thường thấy:
±3%
được gọi là margin of error.
Nhưng con số này chỉ có ý nghĩa khi đi cùng các giả định như:
- sampling design;
- sample size;
- confidence level;
- ước lượng đang xem;
- cách weighting.
Không nên lấy một công thức đơn giản rồi dùng cho mọi dataset bất kể sample được tạo thế nào.
Confidence Interval
Confidence Interval là khoảng ước lượng được xây dựng từ sample theo một phương pháp thống kê cụ thể.
Nó giúp biểu diễn uncertainty của estimate.
Nhưng confidence interval chỉ xử lý một phần uncertainty.
Nó không tự sửa:
- sampling bias;
- measurement error;
- data quality;
- nonresponse;
- confounding;
- questionnaire bias.
Một confidence interval rất hẹp quanh một estimate bị bias vẫn có thể rất chính xác quanh một câu trả lời sai.
Lấy mẫu trong Data Analytics
Sampling không chỉ xuất hiện trong khảo sát.
Trong Data Analytics mình có thể lấy mẫu để:
- exploratory analysis;
- kiểm tra data quality;
- develop query;
- train model;
- validation;
- manual review;
- quality assurance;
- giảm chi phí tính toán.
Nhưng mỗi mục tiêu có yêu cầu sampling khác nhau.
Lấy mẫu để kiểm tra dữ liệu
Giả sử database có 100 triệu record.
Để hiểu schema hoặc kiểm tra nhanh dữ liệu, mình có thể lấy sample.
Nhưng:
SELECT TOP 100
không tự động là random sample.
Nếu bảng được sắp xếp theo thời gian hoặc một ID nào đó thì 100 record đầu có thể có đặc điểm rất khác dữ liệu còn lại.
Lấy vài dòng đầu không phải sampling ngẫu nhiên
Đây là lỗi rất phổ biến khi làm data.
Mở CSV.
Nhìn 20 dòng đầu.
Rồi kết luận:
Dữ liệu trông ổn.
Hai mươi dòng đầu chỉ cho biết:
Hai mươi dòng đầu trông ổn.
Không nhiều hơn.
Sampling trong Machine Learning
Machine Learning cũng phụ thuộc rất mạnh vào cách dữ liệu được lấy và chia.
Các tập thường gặp:
- training set;
- validation set;
- test set.
Nếu quá trình sampling không phản ánh environment mà model sẽ gặp trong production thì evaluation có thể rất đẹp nhưng model triển khai lại hoạt động kém.
Train Test Split cũng là bài toán lấy mẫu
Một random 80/20 split không phải lúc nào cũng phù hợp.
Ví dụ dữ liệu theo thời gian:
Nếu lấy ngẫu nhiên record từ cả quá khứ và tương lai vào train/test, mình có thể vô tình tạo ra data leakage.
Trong bài toán forecasting, split theo thời gian thường hợp lý hơn.
Sampling design phải phản ánh cách model sẽ được sử dụng thật.
Imbalanced Data
Giả sử fraud chỉ chiếm 0,1% giao dịch.
Một random sample nhỏ có thể chứa quá ít fraud case để phân tích.
Khi đó có thể cần:
- oversampling;
- undersampling;
- stratified sampling;
- class weighting;
- hoặc những kỹ thuật phù hợp khác.
Nhưng nếu thay đổi tỷ lệ class trong sample, mình phải nhớ:
sample distribution không còn giống population distribution.
Oversampling không làm population thay đổi
Nếu fraud thực tế là 0,1% nhưng mình cố ý tạo training set có 10% fraud để model học tốt hơn:
Training sample có 10% fraud.
Population vẫn chỉ có 0,1%.
Điều này ảnh hưởng tới:
- probability calibration;
- metric interpretation;
- threshold;
- evaluation.
Sampling trong A/B Test
Experiment cũng có bài toán sampling và assignment.
Hai việc cần phân biệt:
Sampling → ai tham gia experiment?
Random Assignment → người tham gia được đưa vào treatment hay control thế nào?
Hai chữ random.
Hai mục tiêu khác nhau.
Random Sampling và Random Assignment khác nhau
| Khái niệm | Mục tiêu chính |
|---|---|
| Random Sampling | Hỗ trợ khả năng suy luận từ sample ra population |
| Random Assignment | Hỗ trợ so sánh treatment và control trong causal inference |
Một experiment có thể random assignment rất tốt nhưng sample chỉ gồm một nhóm người dùng đặc biệt.
Kết quả causal trong nhóm đó có thể tốt.
Nhưng khả năng generalize ra toàn population vẫn cần được xem xét.
Lấy mẫu có thay thế Data Quality không?
Không.
Sample có thể được chọn hoàn hảo nhưng dữ liệu bên trong vẫn có:
- missing;
- duplicate;
- measurement error;
- schema inconsistency;
- outlier;
- data freshness problem.
Sampling trả lời:
Mình đang quan sát những ai hoặc những record nào?
Data Quality trả lời:
Những dữ liệu đó có đáng tin không?
Lấy mẫu cũng không thay thế tư duy dữ liệu
Có một sample đẹp không có nghĩa câu hỏi nghiên cứu đã đúng.
Trước khi sampling nên hỏi:
- Mình muốn trả lời câu hỏi gì?
- Population thật sự là ai?
- Đơn vị quan sát là gì?
- Sampling Frame có bao phủ population không?
- Nhóm nào dễ bị bỏ sót?
- Sampling design nào phù hợp?
- Sample size cần bao nhiêu?
- Sẽ xử lý weighting và nonresponse thế nào?
Sampling bắt đầu từ câu hỏi. Không bắt đầu từ hàm random.
Một checklist ngắn trước khi tin một sample
Khi đọc một nghiên cứu khảo sát hoặc báo cáo, tôi thường muốn biết:
- Population là gì?
- Sample size bao nhiêu?
- Sample được chọn thế nào?
- Sampling Frame là gì?
- Response rate bao nhiêu?
- Có weighting không?
- Có nhóm nào bị thiếu?
- Kết quả đang được generalize tới ai?
Nếu báo cáo chỉ nói:
Khảo sát 5.000 người.
thì 5.000 vẫn chưa cho mình đủ thông tin để đánh giá chất lượng sampling.
Nếu chỉ nhớ một điều
Lấy mẫu dữ liệu không phải chọn một ít dữ liệu cho nhanh. Đó là thiết kế cách một phần dữ liệu đại diện đủ tốt cho câu hỏi mà mình muốn trả lời.
Tag Lấy mẫu dữ liệu tổng hợp các bài viết và kiến thức về Population Sample Sampling Frame Random Sampling Stratified Sampling Cluster Sampling Sample Size Sampling Bias Margin of Error và cách lựa chọn dữ liệu phù hợp trong thống kê phân tích dữ liệu Machine Learning và experiment.