 English (EN)

Lấy mẫu dữ liệu là gì? Hiểu Sampling Bias qua ví dụ thực tế
Xem nhanh:
- 1. Lấy mẫu dữ liệu là gì?
- 2. Một ví dụ: Hỏi 100 người, kết quả 72%, nhưng toàn bộ khách hàng chỉ có 48% hài lòng
- 3. Sampling Bias là gì?
- 4. Lấy mẫu ngẫu nhiên có giải quyết được vấn đề không?
- 5. Lấy mẫu phân tầng: Khi chúng ta đã biết các nhóm khách hàng
- 6. Nếu đã khảo sát lệch nhóm, có thể dùng trọng số để điều chỉnh không?
- 7. Sai số lấy mẫu khác với sai lệch chọn mẫu như thế nào?
- 8. Hỏi 100 người thì sai số bao nhiêu?
- 9. Khảo sát 1.000 người có chắc tốt hơn khảo sát 100 người?
- 10. Câu hỏi khảo sát cũng có thể khiến dữ liệu sai lệch
- 11. Thực hành Excel: Tính tỷ lệ mẫu và điều chỉnh trọng số
- 12. Thực hành Python: Chọn ngẫu nhiên 100 khách hàng
- 13. Trước khi thực hiện một khảo sát, Nha muốn kiểm tra điều gì?
- 14. Từ một khảo sát nhỏ đến cách chúng ta ra quyết định
- Tài liệu tham khảo
Giả sử một cửa hàng trực tuyến muốn biết khách hàng có hài lòng với trải nghiệm mua sắm hay không.
Nhân viên gửi khảo sát và nhận được 100 câu trả lời. Trong đó, 72 người cho biết họ hài lòng.
Kết quả được đưa lên báo cáo:
72% khách hàng hài lòng với trải nghiệm mua sắm.
Một con số khá đẹp.
Nhưng chú Nha 27 tuổi lại có một câu hỏi:
100 người trả lời ấy là ai?
Nếu phần lớn họ là những khách hàng đã mua sắm nhiều lần, có thường xuyên nhận ưu đãi và biết rõ cách sử dụng dịch vụ thì sao?
Còn những khách mới, những người chỉ mua một lần rồi không quay lại, có được hỏi hay không?
Biết đâu kết quả 72% hoàn toàn chính xác với 100 người đã trả lời. Nhưng khi sử dụng nó để mô tả toàn bộ khách hàng, chúng ta lại đang đưa ra một kết luận chưa đủ cơ sở.
Hôm nay, Nha muốn tìm hiểu về lấy mẫu dữ liệu (sampling), sai lệch chọn mẫu (sampling bias) và một câu hỏi nghe đơn giản nhưng khá quan trọng: hỏi bao nhiêu người thì mới đủ, và hỏi như thế nào để kết quả đáng tin?
1. Lấy mẫu dữ liệu là gì?
Lấy mẫu dữ liệu, tiếng Anh là sampling, là quá trình lựa chọn một phần các đơn vị từ một tổng thể để quan sát, đo lường hoặc phân tích.
Trong thống kê, chúng ta thường gặp ba khái niệm:
- Population (tổng thể): Toàn bộ các đơn vị mà nghiên cứu muốn tìm hiểu.
- Sample (mẫu): Một phần các đơn vị được chọn từ tổng thể để nghiên cứu.
- Sampling frame (khung lấy mẫu): Danh sách hoặc nguồn thông tin được sử dụng để lựa chọn các đơn vị tham gia mẫu.
Ví dụ, một cửa hàng muốn khảo sát mức độ hài lòng của 1.000 khách hàng đã mua hàng trong tháng vừa qua.
Nếu mỗi khách hàng chỉ được tính một lần, tổng thể nghiên cứu gồm 1.000 khách hàng duy nhất.
Trong trường hợp này, cửa hàng có thể sử dụng danh sách 1.000 mã khách hàng đủ điều kiện làm khung lấy mẫu.
Nếu chọn 100 người để khảo sát, đó là một mẫu có kích thước n = 100.
Nhưng cần nhớ rằng danh sách khách hàng có thể chưa hoàn chỉnh. Một số khách không có thông tin liên hệ, một số tài khoản có thể thuộc cùng một người hoặc có khách hàng không đủ điều kiện theo định nghĩa nghiên cứu.
Vì vậy, khung lấy mẫu phải được kiểm tra trước khi tiến hành lựa chọn.
Hiệp hội Nghiên cứu Dư luận Hoa Kỳ (AAPOR) nhấn mạnh rằng việc xác định tổng thể, xây dựng khung lấy mẫu và lựa chọn phương pháp tuyển chọn người tham gia là những bước quan trọng trong thiết kế khảo sát.
Nguồn: AAPOR – Best Practices for Survey Research.
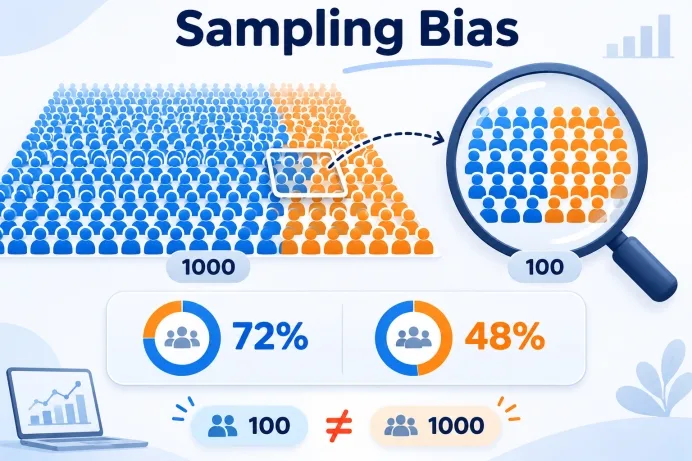
2. Một ví dụ: Hỏi 100 người, kết quả 72%, nhưng toàn bộ khách hàng chỉ có 48% hài lòng
Chúng ta thử xây dựng một bộ dữ liệu giả định.
Một cửa hàng có 1.000 khách hàng trong phạm vi nghiên cứu.
Trong đó:
- 200 khách hàng đã từng mua trước đây và quay lại mua tiếp.
- 800 khách hàng mua lần đầu.
Giả sử chúng ta biết được trạng thái hài lòng của toàn bộ 1.000 khách hàng để dùng làm dữ liệu đối chứng trong bài thực hành.
Trong nghiên cứu thực tế, chúng ta thường không có sẵn thông tin đầy đủ như vậy. Chính vì thế mới cần lấy mẫu.
Dữ liệu tổng thể giả định:
| Nhóm khách hàng | Số khách | Số khách hài lòng | Tỷ lệ hài lòng |
|---|---|---|---|
| Khách quay lại | 200 | 160 | 80% |
| Khách mua lần đầu | 800 | 320 | 40% |
| Tổng cộng | 1.000 | 480 | 48% |
Tỷ lệ hài lòng của toàn bộ khách hàng là:
480 / 1.000 × 100% = 48%.
Bây giờ, nhân viên cửa hàng chọn 100 người để hỏi.
Do muốn khảo sát nhanh, họ chủ yếu tiếp cận những khách hàng quen, dễ liên hệ và thường tương tác với cửa hàng.
Kết quả mẫu được giả định như sau:
| Nhóm được hỏi | Số người trả lời | Hài lòng | Tỷ lệ |
|---|---|---|---|
| Khách quay lại | 80 | 64 | 80% |
| Khách mua lần đầu | 20 | 8 | 40% |
| Tổng cộng | 100 | 72 | 72% |
Có 72 người hài lòng trong 100 người được hỏi.
72 / 100 × 100% = 72%.
Phép tính đúng.
Nhưng nếu dùng tỷ lệ này để mô tả 1.000 khách hàng, chúng ta đang gặp vấn đề.
Trong tổng thể, khách quay lại chỉ chiếm 20%, nhưng trong mẫu khảo sát lại chiếm tới 80%.
Mà nhóm khách quay lại có tỷ lệ hài lòng cao hơn nhóm khách mua lần đầu.
Vì vậy, mẫu đang nghiêng mạnh về nhóm có mức hài lòng cao.
Đó là lý do kết quả mẫu đạt 72%, trong khi tỷ lệ thực của tổng thể giả định chỉ là 48%.
Chênh lệch 24 điểm phần trăm.
Nếu lấy 72% nhân với 1.000 khách hàng rồi khẳng định có khoảng 720 người hài lòng, chúng ta đã ước lượng cao hơn 240 người so với dữ liệu tổng thể giả định.
Không phải vì ai đó trả lời sai.
Vấn đề nằm ở cách chọn người tham gia.
3. Sampling Bias là gì?
Sampling bias, hay sai lệch chọn mẫu, xuất hiện khi quy trình lựa chọn mẫu dẫn đến việc một số nhóm hoặc đặc điểm có xu hướng được đại diện không phù hợp so với tổng thể mục tiêu, từ đó có thể làm sai lệch kết quả ước lượng.
Trong ví dụ của chúng ta, nhóm khách quay lại xuất hiện quá nhiều so với tỷ trọng thực tế.
Vì tỷ lệ hài lòng khác nhau giữa hai nhóm, sự mất cân đối ấy làm kết quả khảo sát lệch khỏi tỷ lệ hài lòng của tổng thể.
Có một điểm cần phân biệt:
Mẫu có cơ cấu khác tổng thể không tự động chứng minh mọi ước lượng đều bị sai lệch. Mức ảnh hưởng còn phụ thuộc vào đặc điểm đang đo, phương pháp chọn mẫu và cách ước lượng.
Nhưng nếu một nhóm có đặc điểm khác biệt rõ rệt về kết quả nghiên cứu bị lấy mẫu quá nhiều hoặc quá ít, đó là một nguy cơ đáng kiểm tra.
Mẫu thuận tiện không phải mẫu ngẫu nhiên
Trong ví dụ trên, nhân viên chọn những khách dễ liên hệ nhất.
Đây là cách lấy mẫu thuận tiện (convenience sampling).
Ưu điểm là dễ triển khai, ít tốn kém và có thể hữu ích cho nghiên cứu khám phá, thử nghiệm bảng hỏi hoặc thu thập phản hồi ban đầu.
Nhưng nó không cho phép chúng ta mặc nhiên suy rộng kết quả cho toàn bộ tổng thể.
Nếu đăng một đường dẫn khảo sát lên mạng xã hội và ai muốn thì trả lời, chúng ta còn phải xem xét thiên lệch tự lựa chọn (self-selection bias).
Những người chủ động trả lời có thể khác những người không trả lời về mức độ quan tâm, trải nghiệm hoặc sự hài lòng.
Pew Research Center phân biệt các mẫu xác suất và không xác suất, đồng thời lưu ý rằng những sai lệch liên quan đến tuyển chọn và không phản hồi có thể ảnh hưởng đáng kể đến chất lượng khảo sát.
Nguồn: Pew Research Center – Evaluating Online Nonprobability Surveys.
4. Lấy mẫu ngẫu nhiên có giải quyết được vấn đề không?
Một cách tiếp cận quan trọng là lấy mẫu ngẫu nhiên đơn (simple random sampling).
Trong phương pháp này, mỗi tập hợp gồm n đơn vị khác nhau từ tổng thể có cùng xác suất được chọn. Vì vậy, mỗi đơn vị riêng lẻ cũng có xác suất được chọn như nhau.
Giả sử chúng ta có danh sách đầy đủ 1.000 khách hàng và muốn chọn 100 người.
Thay vì chọn người quen, chúng ta sử dụng một quy trình ngẫu nhiên để chọn ra 100 mã khách hàng khác nhau.
Mỗi khách có xác suất được đưa vào mẫu là:
100 / 1.000 = 10%.
Tuy nhiên, được chọn không có nghĩa chắc chắn người đó sẽ trả lời khảo sát.
Nếu nhiều khách được chọn từ chối tham gia, và những người từ chối có đặc điểm khác nhóm đã trả lời, kết quả vẫn có thể bị sai lệch do không phản hồi (nonresponse bias).
Đây là lý do lấy mẫu ngẫu nhiên là một nền tảng quan trọng, nhưng không phải chiếc vé bảo đảm mọi khảo sát đều chính xác.
Chúng ta còn phải quan tâm đến khung lấy mẫu, tỷ lệ phản hồi, câu hỏi khảo sát và cách xử lý dữ liệu.
Mẫu ngẫu nhiên có nhất thiết giống hệt tổng thể?
Không.
Trong tổng thể giả định, 20% là khách quay lại.
Một mẫu ngẫu nhiên 100 người có thể chọn được 18, 20 hoặc 24 khách quay lại, thậm chí những số lượng khác.
Chúng ta không bắt buộc phải nhận đúng 20 người thuộc nhóm quay lại trong mọi lần lấy mẫu.
Điểm quan trọng của lấy mẫu xác suất là cách lựa chọn được xác định rõ và cho phép sử dụng lý thuyết thống kê để đánh giá độ bất định của ước lượng, khi những giả định cần thiết được đáp ứng.
Đừng nhầm "ngẫu nhiên" với "chắc chắn đại diện hoàn hảo".
5. Lấy mẫu phân tầng: Khi chúng ta đã biết các nhóm khách hàng
Nếu biết tổng thể có những nhóm khác nhau về đặc điểm quan trọng, chúng ta có thể cân nhắc lấy mẫu phân tầng (stratified sampling).
Ví dụ, chia danh sách 1.000 khách hàng thành hai tầng:
- Tầng 1: 200 khách quay lại.
- Tầng 2: 800 khách mua lần đầu.
Chúng ta muốn lấy tổng cộng 100 người theo tỷ trọng của từng tầng.
Khi đó:
Số khách quay lại cần chọn = 100 × 20% = 20 người.
Số khách mua lần đầu cần chọn = 100 × 80% = 80 người.
Tiếp theo, dùng phương pháp ngẫu nhiên để chọn người trong từng tầng.
Giả sử sau khảo sát, chúng ta thu được đúng bộ kết quả minh họa sau:
| Nhóm | Người được khảo sát | Người hài lòng | Tỷ lệ |
|---|---|---|---|
| Khách quay lại | 20 | 16 | 80% |
| Khách mua lần đầu | 80 | 32 | 40% |
| Tổng | 100 | 48 | 48% |
Tỷ lệ hài lòng trong mẫu là:
(16 + 32) / 100 = 48%.
Con số trùng với tỷ lệ tổng thể trong bài thực hành.
Nhưng cần nói rõ: kết quả được lựa chọn có chủ đích để minh họa phép tính. Trong khảo sát thực tế, dù số người được chọn theo đúng tỷ trọng 20/80, tỷ lệ hài lòng quan sát được ở từng tầng vẫn có thể khác tỷ lệ thật do biến động lấy mẫu.
Lấy mẫu phân tầng không bảo đảm một lần khảo sát sẽ cho kết quả chính xác tuyệt đối.
Nó cho phép chúng ta thiết kế mẫu có chủ đích theo các tầng và áp dụng phương pháp ước lượng phù hợp.
Khi sử dụng phương pháp này, các tầng cần được định nghĩa rõ, không chồng chéo trong phạm vi thiết kế và bao phủ tổng thể mục tiêu.
6. Nếu đã khảo sát lệch nhóm, có thể dùng trọng số để điều chỉnh không?
Đây là một câu hỏi khá thú vị.
Giả sử chúng ta đã có mẫu 100 người ban đầu:
- 80 khách quay lại, trong đó 64 người hài lòng.
- 20 khách mua lần đầu, trong đó 8 người hài lòng.
Tỷ lệ chung không điều chỉnh là 72%.
Nhưng chúng ta biết trong tổng thể, khách quay lại chiếm 20% và khách mua lần đầu chiếm 80%.
Vậy thay vì xem hai nhóm có trọng số theo quy mô mẫu 80/20, chúng ta thử tính theo tỷ trọng tổng thể 20/80.
Công thức ước lượng theo trọng số:
Tỷ lệ hài lòng điều chỉnh = Tỷ trọng khách quay lại × Tỷ lệ hài lòng nhóm quay lại + Tỷ trọng khách mới × Tỷ lệ hài lòng nhóm khách mới.
Thay số:
20% × 80% + 80% × 40% = 48%.
Kết quả điều chỉnh bằng 48%.
Trong ví dụ, nó đúng bằng tỷ lệ tổng thể.
Tuy nhiên, điều đó xảy ra vì chúng ta đã xây dựng bộ dữ liệu sao cho tỷ lệ hài lòng quan sát trong mỗi nhóm đúng bằng tỷ lệ của nhóm trong tổng thể.
Trong dữ liệu thực tế, trọng số không có phép màu như vậy.
Nếu 80 khách quay lại được chọn đều là những người đặc biệt hài lòng, tỷ lệ 80% của nhóm ấy có thể vẫn sai lệch so với toàn bộ khách quay lại.
Việc gán trọng số 20% cho nhóm không tự giải quyết được vấn đề ấy.
Trọng số có thể giúp điều chỉnh những khác biệt đã biết về cơ cấu mẫu, nhưng không tự động sửa được mọi sai lệch do người không tham gia, khung lấy mẫu thiếu hoặc những đặc điểm không được đo lường.
Pew Research Center sử dụng nhiều bước điều chỉnh trọng số trong các cuộc khảo sát, đồng thời công bố phương pháp lấy mẫu và những giới hạn cần chú ý khi diễn giải kết quả.
Nguồn: Pew Research Center – U.S. Survey Methodology.
7. Sai số lấy mẫu khác với sai lệch chọn mẫu như thế nào?
Đây là hai khái niệm dễ bị nhầm với nhau.
Sampling error, hay sai số lấy mẫu, là sự khác biệt có thể xảy ra giữa ước lượng từ mẫu và giá trị tổng thể do chúng ta chỉ quan sát một phần tổng thể.
Chẳng hạn, nếu tỷ lệ hài lòng thật là 48%, một mẫu ngẫu nhiên 100 người có thể cho kết quả 45%, 50% hoặc một giá trị khác.
Những khác biệt này có thể phát sinh do biến động ngẫu nhiên của quá trình lấy mẫu.
Sampling bias lại liên quan đến cách thiết kế hoặc thực hiện chọn mẫu khiến kết quả có nguy cơ bị lệch một cách có hệ thống.
Trong ví dụ 72%, việc chọn quá nhiều khách quay lại là nguyên nhân của sai lệch trong ước lượng không điều chỉnh.
| Đặc điểm | Sampling error | Sampling bias |
|---|---|---|
| Bản chất | Biến động do quan sát một phần tổng thể | Sai lệch có hệ thống từ cơ chế chọn mẫu |
| Tăng kích thước mẫu | Thường giúp giảm sai số ngẫu nhiên | Không tự động loại bỏ sai lệch |
| Cách kiểm soát | Thiết kế mẫu, cỡ mẫu, phương pháp ước lượng | Kiểm tra khung mẫu, tuyển chọn, đại diện các nhóm và các giả định |
Điều Nha muốn ghi nhớ là: tăng số lượng câu trả lời không nhất thiết sửa được một quy trình lựa chọn người trả lời đang bị lệch.
Nếu chỉ tiếp tục hỏi những khách hàng quen, chúng ta có thể thu được 1.000 câu trả lời rất chính xác về nhóm khách hàng quen, nhưng vẫn không biết đầy đủ về những khách khác.
8. Hỏi 100 người thì sai số bao nhiêu?
Giả sử chúng ta thực hiện một cuộc khảo sát ngẫu nhiên đơn hợp lệ, có 100 người trả lời và 48 người hài lòng.
Tỷ lệ quan sát là 48%.
Để minh họa mức độ bất định do chọn mẫu, chúng ta có thể sử dụng công thức xấp xỉ khoảng tin cậy cho một tỷ lệ.
Với mức tin cậy 95%, công thức xấp xỉ đơn giản của biên sai số là:
MOE = 1,96 × SQRT(p × (1 - p) / n)Trong đó:
- MOE là biên sai số lấy mẫu xấp xỉ.
- p là tỷ lệ quan sát dưới dạng số thập phân.
- n là số quan sát trong mẫu.
- 1,96 là hệ số thường được sử dụng cho khoảng tin cậy xấp xỉ 95% theo phân phối chuẩn.
Thay p = 0,48 và n = 100:
MOE = 1,96 × SQRT(0,48 × 0,52 / 100) ≈ 0,0979Tức khoảng 9,8 điểm phần trăm.
Nếu tạm bỏ qua hiệu chỉnh tổng thể hữu hạn, khoảng tin cậy xấp xỉ là:
48% ± 9,8 điểm phần trăm.
Hay khoảng từ 38,2% đến 57,8%.
Đây là một phép xấp xỉ để học công thức, không phải khoảng tin cậy chính thức của cuộc khảo sát giả định ở phần trước.
Trong bài toán lấy mẫu không hoàn lại 100 người từ tổng thể 1.000 người, chúng ta có thể áp dụng thêm hệ số hiệu chỉnh tổng thể hữu hạn:
FPC = SQRT((N - n) / (N - 1))Với N = 1.000 và n = 100, hệ số này xấp xỉ 0,949.
Biên sai số được hiệu chỉnh còn khoảng 9,3 điểm phần trăm, trong các giả định của phép xấp xỉ nêu trên.
Điều quan trọng hơn cả các con số là cách hiểu.
Mức tin cậy 95% không có nghĩa có 95% xác suất một tỷ lệ tổng thể cố định nằm trong một khoảng cụ thể vừa tính, theo cách diễn giải tần suất truyền thống.
Nó mô tả tính chất của phương pháp tạo khoảng: nếu lặp lại quy trình lấy mẫu và lập khoảng tin cậy đủ nhiều lần trong những điều kiện phù hợp, khoảng 95% các khoảng thu được sẽ bao chứa giá trị thật của tổng thể.
Và biên sai số lấy mẫu chỉ phản ánh một phần độ bất định, không bao gồm mọi sai lệch do chọn sai đối tượng, người được chọn không trả lời hoặc câu hỏi khảo sát không tốt.
Đặc biệt, không nên lấy công thức trên rồi gắn nhãn "sai số ±9,8%" cho mẫu thuận tiện 100 người ở ví dụ 72%.
Với mẫu không xác suất, muốn công bố các thước đo độ bất định cần xác định rõ mô hình, giả định và phương pháp phù hợp; không được mặc nhiên sử dụng công thức của mẫu ngẫu nhiên đơn.
Nguồn: Penn State – Inference for One Sample.
Nguồn bổ sung: AAPOR – Disclosure Standards.
9. Khảo sát 1.000 người có chắc tốt hơn khảo sát 100 người?
Không thể trả lời chỉ bằng kích thước mẫu.
Giả sử một cửa hàng có 20.000 khách hàng và muốn tìm hiểu mức độ hài lòng của tất cả khách hàng ấy.
Nhóm thứ nhất khảo sát 1.000 khách hàng thường xuyên sử dụng chương trình thành viên.
Nhóm thứ hai sử dụng một quy trình lấy mẫu xác suất được thiết kế cẩn thận để tiếp cận 400 khách hàng từ khung mẫu phù hợp với tổng thể mục tiêu.
Chúng ta không thể mặc định kết quả của nhóm thứ nhất chính xác hơn chỉ vì có nhiều người trả lời hơn.
Nếu nhóm thành viên có trải nghiệm khác đáng kể với khách không tham gia chương trình, khảo sát 1.000 thành viên có thể không mô tả đúng toàn bộ khách hàng.
Trong khi đó, mẫu 400 người được thiết kế phù hợp có thể cung cấp thông tin hữu ích hơn cho việc suy rộng.
Tuy nhiên, cũng không thể khẳng định mẫu 400 chắc chắn tốt hơn mà không xem chất lượng khung mẫu, tỷ lệ phản hồi, phương pháp đo và phương sai ước lượng.
Khi các yếu tố khác giữ nguyên, tăng kích thước mẫu thường làm giảm sai số lấy mẫu.
Nhưng một mẫu lớn không bù đắp được mọi vấn đề từ thiết kế nghiên cứu.
Đây là lý do Nha nghĩ câu hỏi "Cần bao nhiêu người?" nên đến sau câu hỏi "Chúng ta cần hiểu ai và chọn họ như thế nào?".
10. Câu hỏi khảo sát cũng có thể khiến dữ liệu sai lệch
Ngay cả khi lựa chọn người tham gia phù hợp, cách đặt câu hỏi vẫn có thể ảnh hưởng đến kết quả.
Hãy xem câu hỏi sau:
Bạn có đồng ý rằng dịch vụ chăm sóc khách hàng tận tâm và chuyên nghiệp của chúng tôi rất tốt không?
Câu hỏi này đưa sẵn những nhận định tích cực vào cách diễn đạt.
Nó cũng gom nhiều khái niệm như tận tâm, chuyên nghiệp và chất lượng dịch vụ vào cùng một câu.
Một cách hỏi trung lập hơn:
Bạn đánh giá mức độ hài lòng với trải nghiệm chăm sóc khách hàng trong lần liên hệ gần nhất như thế nào?
Chúng ta có thể cung cấp các lựa chọn từ rất không hài lòng đến rất hài lòng, kèm lựa chọn không nhớ hoặc không áp dụng khi cần.
Ngoài nội dung câu hỏi, còn phải xem thứ tự câu hỏi, cách hiển thị lựa chọn, thời điểm khảo sát và người thực hiện.
AAPOR khuyến nghị câu hỏi khảo sát nên rõ ràng, tập trung vào một khái niệm, tránh ngôn ngữ dẫn dắt và được kiểm tra trước khi triển khai rộng.
Nguồn: AAPOR – Best Practices for Survey Research.
Điều này cũng cho thấy dữ liệu khảo sát không chỉ phụ thuộc vào người trả lời.
Nó còn phụ thuộc vào cách chúng ta đặt câu hỏi để thu thập câu trả lời.
11. Thực hành Excel: Tính tỷ lệ mẫu và điều chỉnh trọng số
Chúng ta quay lại ví dụ 100 người, gồm 80 khách quay lại và 20 khách mua lần đầu.
Hãy tạo bảng trong Excel hoặc Google Sheets:
| Cột A | Cột B | Cột C | Cột D |
|---|---|---|---|
| Nhóm | Số khách tổng thể | Số người khảo sát | Người hài lòng |
| Quay lại | 200 | 80 | 64 |
| Mua lần đầu | 800 | 20 | 8 |
Giả sử tiêu đề ở hàng 1, dữ liệu ở hàng 2 và 3.
Bước 1: Tính tỷ lệ hài lòng của từng nhóm
Tại E1 nhập "Tỷ lệ hài lòng".
Ô E2:
=D2/C2Ô E3:
=D3/C3Định dạng kết quả thành phần trăm.
Chúng ta được 80% và 40%.
Bước 2: Tính tỷ lệ không trọng số
=SUM(D2:D3)/SUM(C2:C3)Kết quả: 72%.
Bước 3: Tính tỷ lệ theo cơ cấu tổng thể
Đầu tiên, tính tỷ trọng tổng thể của mỗi nhóm.
Ô F2:
=B2/SUM($B$2:$B$3)Ô F3:
=B3/SUM($B$2:$B$3)Kết quả là 20% và 80%.
Sau đó tính trung bình có trọng số:
=SUMPRODUCT(E2:E3,F2:F3)Kết quả: 48%.
Như vậy, chúng ta vừa kiểm tra được hai phép tính:
- Tỷ lệ hài lòng không trọng số trong mẫu: 72%.
- Tỷ lệ điều chỉnh theo tỷ trọng hai nhóm: 48%.
Trong ví dụ, tỷ lệ trong từng nhóm được xây dựng bằng tỷ lệ thật của tổng thể để làm rõ tác động của cơ cấu mẫu.
Trong thực tế, cần kiểm tra thêm khả năng sai lệch ngay bên trong từng nhóm trước khi sử dụng kết quả điều chỉnh để đưa ra quyết định.
12. Thực hành Python: Chọn ngẫu nhiên 100 khách hàng
Python có sẵn module random để thực hành việc lựa chọn mẫu.
Chúng ta sẽ tạo một bộ dữ liệu mô phỏng gồm 1.000 khách hàng, với tỷ lệ hài lòng đúng theo bảng tổng thể ban đầu.
Mỗi phần tử là một khách hàng, gồm tên nhóm và trạng thái hài lòng. Giá trị 1 là hài lòng, 0 là không hài lòng theo quy ước đơn giản hóa của ví dụ.
import random

# Du lieu tong the gia dinh population = (

[("quay_lai", 1)] * 160

+ [("quay_lai", 0)] * 40

+ [("lan_dau", 1)] * 320

+ [("lan_dau", 0)] * 480 )

# Khoi tao bo sinh so ngau nhien rng = random.Random(27)

# Chon 100 khach khong lap sample = rng.sample(population, 100)

# Tinh ty le hai long population_rate = (

sum(person[1] for person in population)

/ len(population) )

sample_rate = (

sum(person[1] for person in sample)

/ len(sample) )

returning_count = sum(

person[0] == "quay_lai"

for person in sample )

print("Tong the:", len(population)) print("Ty le tong the:", f"{population_rate:.1%}") print("Co mau:", len(sample)) print("Khach quay lai:", returning_count) print("Ty le trong mau:", f"{sample_rate:.1%}")
Trong lần chạy kiểm tra với bộ sinh số ngẫu nhiên được khởi tạo bằng seed 27, kết quả là:
Tong the: 1000 Ty le tong the: 48.0% Co mau: 100 Khach quay lai: 20 Ty le trong mau: 47.0%Kết quả mẫu là 47%, trong khi tỷ lệ tổng thể là 48%.
Ở lần chạy này, kết quả khá gần.
Nhưng điều đó không có nghĩa cứ dùng mẫu ngẫu nhiên 100 người thì sẽ đạt độ chính xác tương tự.
Hãy thay số 27 trong random.Random(27) thành 42, 2026 hoặc một giá trị khác rồi chạy lại.
Bạn sẽ thấy số khách quay lại được chọn và tỷ lệ hài lòng trong mẫu có thể thay đổi.
Đây là một cách đơn giản để quan sát biến động lấy mẫu.
Việc cố định seed giúp tái hiện quá trình thực hành trong cùng môi trường, không làm cho mẫu trở nên đại diện hơn hoặc giảm sai số thống kê.
Trong nghiên cứu thật, dữ liệu thường không được tạo sẵn với tỷ lệ tổng thể đã biết. Chúng ta phải xây dựng khung mẫu, lựa chọn người đủ điều kiện và thu thập phản hồi theo quy trình nghiên cứu.
13. Trước khi thực hiện một khảo sát, Nha muốn kiểm tra điều gì?
Sau những phép tính trên, Nha thử xây dựng một danh sách câu hỏi ngắn để sử dụng khi lập kế hoạch khảo sát.
- Chúng ta cần hiểu ai? Toàn bộ khách hàng, khách mua trong tháng, khách mới hay khách từng hủy đơn?
- Tổng thể được định nghĩa như thế nào? Có tính mỗi khách một lần không, và giới hạn thời gian là gì?
- Danh sách dùng để lấy mẫu có đầy đủ không? Nhóm nào có thể bị bỏ sót?
- Người tham gia được chọn bằng cách nào? Ngẫu nhiên, phân tầng, thuận tiện hay tự nguyện?
- Ai đã được mời nhưng không trả lời? Người phản hồi có thể khác người không phản hồi ở những đặc điểm nào?
- Câu hỏi có trung lập không? Cách hỏi có khiến người tham gia hiểu sai hoặc nghiêng về một lựa chọn không?
- Có cần trọng số không? Nếu có, trọng số dựa trên thông tin nào và những giả định gì?
- Sai số được báo cáo đúng chưa? Có phân biệt sai số lấy mẫu với các nguồn sai lệch khác không?
Với những khảo sát quan trọng, nên công bố hoặc lưu trữ tài liệu phương pháp gồm quy mô mẫu, cách tuyển chọn, thời gian, kênh khảo sát, câu hỏi và quy tắc xử lý dữ liệu.
Đó là cách để người khác hiểu được kết quả đã được tạo ra như thế nào.
14. Từ một khảo sát nhỏ đến cách chúng ta ra quyết định
Có một điều Nha thấy đáng suy nghĩ sau bài thực hành này.
Chúng ta thường chú ý đến những gì dữ liệu đang nói.
Nhưng đôi khi, điều cần hỏi trước lại là dữ liệu đang đại diện cho ai.
Một cửa hàng có thể nhận được hàng trăm lời khen từ khách hàng trung thành. Đó là những lời khen có giá trị.
Nhưng nếu muốn hiểu trải nghiệm của tất cả khách hàng, chỉ đọc lời khen có thể chưa đủ.
Chúng ta cũng cần tìm cách lắng nghe khách mới, khách ít tương tác và những người đã ngừng sử dụng dịch vụ, nếu họ thuộc tổng thể nghiên cứu.
Trong bài Dữ liệu thiếu, dữ liệu trùng: Khi nào nên sửa, khi nào không nên xóa?, Nha từng chia sẻ rằng dữ liệu có thể sai lệch ngay ở bước xử lý nếu chúng ta không hiểu ý nghĩa của từng bản ghi.
Bài hôm nay đi lùi thêm một bước.
Trước khi làm sạch, trước khi tính trung bình, trước khi vẽ dashboard, chúng ta phải xem dữ liệu được thu thập từ ai và bằng cách nào.
Bởi vì nếu một nhóm quan trọng chưa bao giờ có cơ hội xuất hiện trong mẫu, việc làm sạch bảng dữ liệu sau đó không tự bổ sung được tiếng nói của họ.
Vậy hỏi 100 người có đủ không?
Có thể đủ cho một mục tiêu nghiên cứu nhất định, với mức độ chính xác được chấp nhận và thiết kế phù hợp.
Cũng có thể chưa đủ.
Điều đáng quan tâm không chỉ là con số 100.
Mà là chúng ta đã chọn 100 người ấy như thế nào, muốn suy luận đến đâu và sẵn sàng thừa nhận những giới hạn nào của kết quả.
Lần tới, khi đọc một báo cáo ghi rằng "72% khách hàng hài lòng", chú Nha 27 tuổi vẫn thấy đây có thể là một tín hiệu tốt.
Nhưng trước khi dùng con số ấy để đưa ra quyết định, Nha muốn hỏi thêm:
72% của ai?
Và những người chưa được hỏi có thể đang nghĩ gì?
Biết đâu câu trả lời sẽ giúp chúng ta cải thiện trải nghiệm của nhiều khách hàng hơn.
Tài liệu tham khảo
Toàn bộ số liệu khách hàng và tỷ lệ hài lòng trong bài đều là ví dụ giả định do tác giả xây dựng. Các khái niệm và phương pháp được đối chiếu với những nguồn sau:
- AAPOR – Best Practices for Survey Research. Thiết kế tổng thể, khung lấy mẫu, chọn mẫu và xây dựng câu hỏi khảo sát.
- AAPOR – Disclosure Standards. Những thông tin phương pháp cần công bố khi báo cáo kết quả nghiên cứu.
- Pew Research Center – U.S. Survey Methodology. Cách tiếp cận tổng sai số khảo sát và phương pháp tuyển chọn, điều chỉnh mẫu.
- Pew Research Center – Evaluating Online Nonprobability Surveys. So sánh mẫu xác suất và mẫu không xác suất.
- Penn State – Inference for One Sample. Công thức và điều kiện xây dựng khoảng tin cậy cho tỷ lệ.
- Penn State – Confidence Intervals and Sample Size. Lý thuyết lấy mẫu, ước lượng và kích thước mẫu.
Mãnh Tử Nha – Chú Nha 27 tuổi, tự học mỗi ngày và chia sẻ lại những điều mình thấy hữu ích.
Cảm ơn bạn đã đọc hết bài viết!
Bài viết sau
Giới thiệu
- Nguyễn Văn Nha
- Mãnh Tử Nha
- 11/07
- Developer - Blogger - Marketer
- Đồng Văn Cống, Thành phố Hồ Chí Minh
- Chat ngay
- 0393 314 999
- [email protected]
- Follow me on Facebook
- Follow me on twitter
- Mãnh Tử Nha Channel
- Follow me on Linkedin
- Follow me on Zalo
- Follow me on Tiktok
- Follow me on Strava
- www.manhtunha.com
- www.NHA.one
Tìm kiếm Google
Tài trợ
Bài viết mới nhất
 Lấy mẫu dữ liệu là gì? Hiểu Sampling Bias qua ví dụ thực tế
 Tam giác phơi sáng là gì? Cách phối hợp khẩu độ, tốc độ màn trập và ISO khi chụp ảnh
 Học nghề qua sách vở là một chuyện, làm thật lại là chuyện khác
 Đọc báo ngày 22 tháng 11 năm 2026: AI tuyên bố giải bài toán 160 năm, nhưng khoa học chưa thể vội tin
 Idempotency là gì? Vì sao bấm thanh toán hai lần mà hệ thống chỉ được xử lý một lần?
Có thể bạn thích
Xem nhiều nhất
 Bài học từ ba con chuột61.140 lượt xem
 Người chiến thắng59.051 lượt xem
 Bảng xếp hạng các Pokémon theo chỉ số CP56.897 lượt xem

 Bài học về sự tự cao55.508 lượt xem
Bài viết ngẫu nhiên


Từ điển Thuật ngữ
342+ khái niệm về AI, Lập trình, Dữ liệu, Nhiếp ảnh & Chạy bộ được Nha định nghĩa rõ ràng, dễ hiểu:
Liên kết


