 Tiếng Việt (VN)

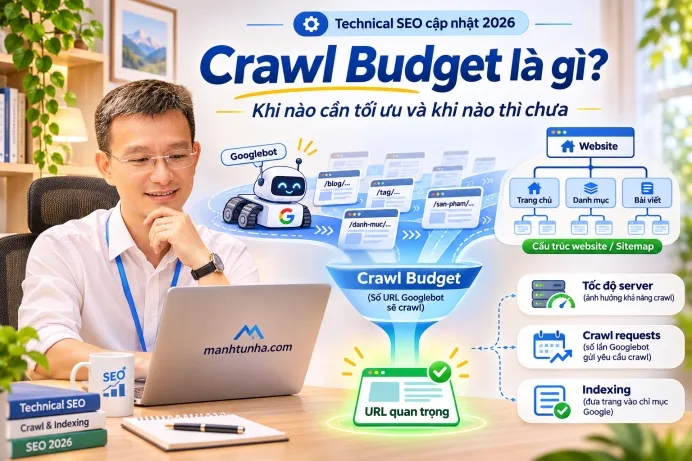
Crawl Budget là gì? Blog vài nghìn URL có thật sự cần tối ưu không?
Xem nhanh:
- Crawl Budget là gì?
- Crawl Capacity Limit là gì?
- Crawl Demand là gì?
- Server rất mạnh không có nghĩa Google sẽ crawl thật nhiều
- Website nào thật sự cần quan tâm Crawl Budget?
- Vậy blog vài nghìn URL có cần tối ưu Crawl Budget không?
- Với manhtunha.com thì sao?
- Thứ đáng kiểm tra không phải Budget trước, mà là URL Inventory
- URL Inventory quan trọng hơn việc “xin thêm Crawl Budget”
- Duplicate URL có thể lãng phí crawling
- Canonical có giúp Crawl Budget không?
- robots.txt và Crawl Budget
- noindex có tiết kiệm Crawl Budget không?
- 404 và 410 đôi khi tốt hơn giữ URL chết
- Soft 404 có thể làm lãng phí Crawl Budget
- Redirect Chain cũng tốn crawl
- Sitemap giúp sử dụng Crawl Budget tốt hơn thế nào?
- lastmod có vai trò gì?
- Page Load Speed ảnh hưởng Crawl Budget không?
- 304 Not Modified là một chi tiết rất hay
- ETag và If-Modified-Since
- Có nên cố làm Googlebot crawl nhiều hơn?
- Crawl nhiều không đồng nghĩa Index nhiều
- Discovered - currently not indexed mới đáng nhìn khác
- Crawl Stats trong Search Console có gì đáng xem?
- Ví dụ: response time tăng cùng lúc crawl giảm
- Ví dụ: Google crawl hàng loạt URL parameter
- Server Log mới là dữ liệu crawl thật
- Nhưng nhớ xác minh Googlebot
- Crawl Depth có phải Crawl Budget không?
- Internal Link có làm tăng Crawl Budget không?
- Quality có liên quan Crawl Demand không?
- Website migration có thể làm Crawl Demand tăng
- Subdomain có Crawl Budget riêng không?
- CSS, JavaScript và ảnh có tốn Crawl Budget không?
- “Tối ưu Crawl Budget” sai cách trông thế nào?
- Vậy tối ưu Crawl Budget đúng là làm gì?
- Cách Nha biết manhtunha.com chưa cần ám ảnh Crawl Budget
- Checklist Crawl Budget Nha sẽ dùng
- Những điều Nha không làm chỉ để “tối ưu Crawl Budget”
- Crawl Budget có quan trọng với AI Search không?
- Bạn nên mang gì về sau bài này?
- Nguồn và tài liệu tham khảo
Có một giai đoạn Nha đọc khá nhiều checklist Technical SEO.
Trong đó thường có một mục nghe rất chuyên nghiệp:
Tối ưu Crawl Budget.
Nghe quan trọng.
Google có một ngân sách dành cho website.
Mình phải tiết kiệm.
Nếu không Googlebot tiêu hết tiền trước khi crawl tới bài quan trọng.
Nghe cũng hợp lý.
Nhưng rồi Nha đọc lại tài liệu Google.
Google nói khá thẳng:
Nếu website không có rất nhiều trang thay đổi nhanh, hoặc những trang mới vẫn được crawl trong thời gian hợp lý, bạn có thể không cần quan tâm tới hướng dẫn Crawl Budget nâng cao.
Ủa.
Vậy hóa ra có khi mình đang tối ưu một vấn đề...
mà website chưa hề gặp.
Crawl Budget là gì?
Theo tài liệu Google hiện tại, Crawl Budget có thể hiểu là tập hợp những URL mà Google:
có thể crawl
và:
muốn crawl.
Hai chữ này quan trọng như nhau.
Google diễn giải Crawl Budget dựa trên hai thành phần lớn:
- Crawl Capacity Limit – khả năng hệ thống của website chịu được lượng crawl;
- Crawl Demand – nhu cầu Google muốn crawl nội dung đó.
Có thể hình dung:
Crawl Budget = Google có thể crawl bao nhiêu + Google muốn crawl bao nhiêuKhông phải:
Website có 10.000 URL → Google cấp đúng 3.000 lượt crawl/ngàyKhông có một con số cố định như vậy.
Crawl Capacity Limit là gì?
Googlebot không muốn crawl tới mức làm server của Nha nghẹt thở.
Vì vậy Google theo dõi khả năng phản hồi của host.
Nếu website:
- phản hồi nhanh;
- ổn định;
- Time to First Byte tốt;
- ít lỗi server;
Google có thể tăng mức crawl capacity theo thời gian.
Ngược lại, nếu server:
- chậm;
- timeout;
- trả nhiều 5xx;
- hoặc 429 Too Many Requests;
Google sẽ giảm tốc để tránh làm website quá tải.
Nói đơn giản:
Server khỏe thì Google có thể đi nhanh hơn.
Nhưng:
Google có thể đi nhanh hơn không có nghĩa Google nhất định muốn đi nhanh hơn.
Đó là phần thứ hai.
Crawl Demand là gì?
Crawl Demand là nhu cầu của Google trong việc crawl hoặc crawl lại URL.
Google hiện nói demand có thể chịu ảnh hưởng bởi:
- quy mô website;
- tần suất cập nhật;
- chất lượng trang;
- mức độ liên quan;
- độ phổ biến;
- độ cũ của dữ liệu mà Google đang có.
Ví dụ một bài:
Giá vàng hôm nay
có nhu cầu freshness khác với:
API là gì?
Một bài có thể cần crawl lại thường xuyên.
Bài kia vài tháng không thay đổi cũng chẳng sao.
Server rất mạnh không có nghĩa Google sẽ crawl thật nhiều
Đây là một hiểu lầm khá hay.
Giả sử Nha nâng server:
4 CPU → 32 CPU 8 GB RAM → 128 GB RAMWebsite chạy nhanh như gió.
Crawl Capacity có thể tăng.
Nhưng nếu Google không thấy nhu cầu crawl thêm thì:
Googlebot vẫn không nhất thiết crawl nhiều hơn.
Bởi Crawl Budget là:
Capacity + DemandKhông phải chỉ Capacity.
Website nào thật sự cần quan tâm Crawl Budget?
Đây là phần Nha thấy đáng đọc nhất trong tài liệu Google 2026.
Google cho biết hướng dẫn Crawl Budget nâng cao chủ yếu dành cho:
Website rất lớn
Khoảng:
1.000.000+ URLvà nội dung thay đổi tương đối thường xuyên, ví dụ mỗi tuần.
Website từ khoảng 10.000 URL trở lên
nhưng nội dung thay đổi rất nhanh:
hằng ngàyVí dụ:
- e-commerce lớn;
- marketplace;
- classified;
- news;
- inventory thay đổi liên tục.
Website có rất nhiều URL ở trạng thái
Discovered - currently not indexedĐây là trường hợp đáng quan tâm kể cả website chưa tới hàng triệu URL.
Google cũng lưu ý các con số trên chỉ là:
ước lượng gần đúng.
Không phải ngưỡng luật cứng.
Vậy blog vài nghìn URL có cần tối ưu Crawl Budget không?
Thông thường:
không cần tối ưu nâng cao.
Google thậm chí nói nếu:
- website không quá lớn;
- nội dung không thay đổi cực nhanh;
- các bài mới vẫn được crawl trong thời gian hợp lý;
thì việc:
- giữ sitemap cập nhật;
- theo dõi Page Indexing Report;
thường đã đủ.
Nha thấy câu này giải phóng khá nhiều thời gian.
Thay vì ngồi tối ưu:
Crawl Budget 0,0001%.
Nha có thể đi sửa:
- nội dung cũ;
- Internal Link;
- title;
- category;
- tag mỏng;
- server error;
- hay URL duplicate.
Những thứ thực sự tồn tại.
Với manhtunha.com thì sao?
Nha không xem manhtunha.com là một website cần chiến lược Crawl Budget nâng cao chỉ vì blog đã tồn tại gần 10 năm.
Tuổi website không quyết định Crawl Budget.
Số lượng URL và cách Google crawl mới đáng quan tâm.
Nếu bài mới:
- được Google phát hiện;
- được crawl tương đối nhanh;
- server ổn định;
- không có hàng loạt Discovered - currently not indexed;
thì Nha không có lý do để viết một robots.txt 300 dòng chỉ để:
Tối ưu Crawl Budget.
Nhưng blog lâu năm vẫn có vài thứ đáng kiểm tra.
Thứ đáng kiểm tra không phải Budget trước, mà là URL Inventory
Google hiện nói một trong những thứ chủ website có thể kiểm soát mạnh nhất là:
Perceived Inventory.
Tức là tập URL mà Google biết website đang có.
Ví dụ website thực sự có:
800 bài hữu íchnhưng hệ thống sinh thêm:
4.000 tag URL 3.000 parameter URL 2.000 search URL 1.500 duplicate URLthì Google không chỉ nhìn thấy 800 bài.
Google có thể nhìn thấy cả một rừng URL.
Đây mới là thứ đáng xử lý.
URL Inventory quan trọng hơn việc “xin thêm Crawl Budget”
Google nói nếu crawler dành quá nhiều thời gian cho những URL:
- duplicate;
- không quan trọng;
- đã xóa;
- không cần crawl;
thì việc crawl các phần còn lại có thể kém hiệu quả hơn.
Vì vậy câu hỏi Nha thích là:
Google đang crawl những URL nào mà mình chẳng cần Google crawl?
Thay vì:
Làm sao xin Google thêm ngân sách?
Duplicate URL có thể lãng phí crawling
Ví dụ:
/article /article?utm_source=facebook /article?ref=homepage /article?sort=abcNếu Google phải crawl cả bốn để cuối cùng nhận ra:
À, cùng một nội dung.
thì website đang tạo thêm công việc không cần thiết.
Nha đã viết kỹ về việc hợp nhất URL trong bài Canonical URL là gì? Vì sao Google chọn URL khác?.
Canonical có giúp Crawl Budget không?
Có thể giúp Google hiểu URL duplicate.
Nhưng cần phân biệt:
Canonical không ngăn Google crawl URL phụ ngay từ đầu.
Google phải crawl trang trong nhiều trường hợp để phát hiện canonical.
Nếu có thể loại bỏ duplicate URL ngay từ routing hoặc redirect đúng thì còn sạch hơn.
Ví dụ:
http → 301 https www → 301 non-wwwthay vì để mọi phiên bản cùng tồn tại rồi hy vọng canonical giải quyết hết.
robots.txt và Crawl Budget
Trong bài robots.txt là gì?, Nha đã nhấn mạnh robots.txt chủ yếu kiểm soát crawling.
Với Crawl Budget, robots.txt có thể hữu ích cho những URL mà Nha thực sự không muốn Google crawl.
Ví dụ:
- search nội bộ;
- sort/filter vô hạn;
- calendar URL;
- một số parameter không có giá trị;
- workflow kỹ thuật.
Nhưng Google có một lưu ý đáng nhớ:
Đừng dùng robots.txt chỉ để tạm thời “giải phóng Crawl Budget” với hy vọng Google sẽ chuyển phần ngân sách đó sang URL khác.
Google chỉ có khả năng chuyển crawl activity nếu website thực sự đang chạm Crawl Capacity Limit.
Blog nhỏ thường chưa tới mức này.
noindex có tiết kiệm Crawl Budget không?
Không phải công cụ tốt nếu mục tiêu duy nhất là giảm crawl.
Để Google biết một trang có:
noindexGoogle vẫn phải crawl trang đó.
Google tới.
Tải response.
Đọc:
À, không index.
Rồi bỏ.
Nếu URL thực sự không bao giờ cần Google crawl và việc chặn phù hợp với mục đích website, robots.txt có thể tiết kiệm crawling hơn.
Nhưng nhớ:
crawl và index là hai bài toán khác nhau.
404 và 410 đôi khi tốt hơn giữ URL chết
Ví dụ Nha đã xóa một URL vĩnh viễn.
Không có nội dung thay thế.
Google nói trả:
404hoặc:
410là tín hiệu mạnh rằng URL không cần được crawl thường xuyên trong tương lai.
Ngược lại, nếu chặn URL chết bằng robots.txt, Google vẫn biết URL tồn tại trong crawl queue và có thể giữ nó lâu hơn.
Đây là một ví dụ rất hay cho việc:
robots.txt không phải thuốc chữa mọi URL.
Soft 404 có thể làm lãng phí Crawl Budget
Soft 404 là tình huống trang có vẻ không có nội dung thật nhưng server vẫn trả:
200 OKVí dụ:
Không tìm thấy bài viết.
nhưng HTTP response vẫn là:
200Google có thể tiếp tục crawl những URL này.
Nếu có hàng chục nghìn soft 404 thì đây mới là vấn đề đáng quan tâm.
Không chỉ vì index.
Mà còn vì crawl efficiency.
Redirect Chain cũng tốn crawl
Ví dụ:
A ↓ 301 B ↓ 301 C ↓ 301 DGoogle phải đi qua nhiều bước để tới URL cuối.
Google hiện nói redirect chain dài có tác động tiêu cực tới crawling.
Nha thích:
A ↓ Dnếu có thể.
Đây vừa tốt cho:
- crawler;
- server;
- người dùng.
Sitemap giúp sử dụng Crawl Budget tốt hơn thế nào?
Trong bài Sitemap XML là gì?, Nha đã nói sitemap nên chứa những URL chính mà mình muốn Google quan tâm.
Với Crawl Budget cũng vậy.
Sitemap không nên chứa:
- redirect;
- 404;
- noindex;
- duplicate URL;
- parameter không cần thiết.
Sitemap sạch giúp Google có một inventory tốt hơn về:
Đây là phần nội dung tôi thực sự quan tâm.
lastmod có vai trò gì?
Nếu một URL được cập nhật thật, sitemap có thể dùng:
<lastmod>để giúp Google biết trang đã thay đổi.
Nhưng Nha không đổi:
lastmod = hôm naycho toàn site mỗi ngày.
Google chỉ có lý do tin tín hiệu nếu tín hiệu chính xác.
Freshness giả không tạo thêm demand lâu dài.
Page Load Speed ảnh hưởng Crawl Budget không?
Có thể ảnh hưởng tới khả năng crawl.
Googlebot bị giới hạn bởi:
- bandwidth;
- thời gian;
- kết nối;
- server response;
- rendering resources.
Nếu trang tải nhanh hơn, Google có thể đọc được nhiều nội dung hơn trong cùng tài nguyên crawl.
Nhưng đây là chỗ cần tránh một kết luận sai:
Web nhanh → Google crawl nhiều → ranking cao.
Không có công thức như vậy.
Google nói rõ tăng crawl rate không tự động làm ranking tốt hơn.
304 Not Modified là một chi tiết rất hay
Đây là phần developer trong Nha khá thích.
Nếu Googlebot đã crawl một URL trước đó và nội dung chưa thay đổi, server có thể trả:
304 Not Modifiedthay vì gửi lại toàn bộ HTML.
Google có thể dùng lại phiên bản đã crawl trước.
Điều này giúp tiết kiệm:
- bandwidth;
- server processing;
- thời gian crawl.
Google hiện khuyến nghị hỗ trợ HTTP caching và 304 nếu phù hợp.
Đây mới là một ví dụ tối ưu Crawl Budget có cơ sở kỹ thuật.
Không phải:
Giảm 3 link footer để Googlebot đỡ mệt.
ETag và If-Modified-Since
Google crawler có thể gửi các header như:
If-Modified-Sincehoặc:
If-None-Matchtrong một số request.
Server có thể dựa vào:
- Last-Modified;
- ETag;
để xác định nội dung có thay đổi hay không.
Nếu chưa đổi:
304 Not Modifiedlà một response rất nhẹ.
Với hệ thống có lượng nội dung lớn, đây là thứ Nha sẽ quan tâm hơn nhiều trò “crawl budget hack”.
Có nên cố làm Googlebot crawl nhiều hơn?
Không phải lúc nào.
Câu hỏi đúng hơn:
Google có đang crawl đủ những URL quan trọng không?
Nếu:
- bài mới được crawl;
- bài cập nhật được recrawl;
- không có backlog lớn;
- server không quá tải;
thì:
có thể chẳng cần thêm gì cả.
Nhiều crawl request hơn không phải KPI SEO.
Crawl nhiều không đồng nghĩa Index nhiều
Nha đã viết về chuyện này trong bài Indexing là gì? Vì sao Google đã crawl bài nhưng vẫn không lập chỉ mục?.
Có thể:
Google crawl 10.000 URL ↓ chỉ index 5.000Vì sau crawling còn:
- duplicate consolidation;
- canonicalization;
- quality assessment;
- index selection.
Vì vậy nếu vấn đề là:
Crawled - currently not indexedthì xin thêm Crawl Budget chưa chắc giải quyết gì.
Google đã crawl rồi.
Vấn đề nằm sau bước crawl.
Discovered - currently not indexed mới đáng nhìn khác
Nếu Search Console có rất nhiều URL:
Discovered - currently not indexedthì câu chuyện khác.
Google biết URL.
Nhưng chưa crawl.
Khi đó cần kiểm tra:
- Google có biết quá nhiều URL phụ không?
- Internal Link có yếu không?
- Sitemap có sạch không?
- robots.txt có chặn nhầm không?
- server có lỗi không?
- crawl demand có thấp không?
- website có đang tạo infinite URL space không?
Đây là lúc Crawl Budget bắt đầu trở thành câu hỏi hợp lý.
Crawl Stats trong Search Console có gì đáng xem?
Nếu nghi có vấn đề crawling, Nha sẽ mở:
Google Search Console → Settings → Crawl statsỞ đây có thể xem:
- tổng số crawl request;
- download size;
- average response time;
- response code;
- file type;
- Googlebot type;
- crawl purpose;
- host status.
Nha không nhìn một con số riêng lẻ.
Nha tìm pattern.
Ví dụ: response time tăng cùng lúc crawl giảm
Nếu thấy:
Server response time ↑ 5xx ↑ Crawl requests ↓thì khá đáng điều tra.
Google có thể đang tự giảm crawl để không gây thêm áp lực cho server.
Ví dụ: Google crawl hàng loạt URL parameter
Nếu server log cho thấy Googlebot liên tục đi vào:
?sort= ?filter= ?session= ?view= ?foo=trong khi các URL này không có giá trị Search, đó là tín hiệu:
URL inventory đang có vấn đề.
Không phải:
Googlebot xấu tính.
Website đã cho crawler những con đường đó.
Server Log mới là dữ liệu crawl thật
Search Console Crawl Stats cho góc nhìn tổng hợp.
Nếu cần điều tra sâu, Nha sẽ nhìn access log.
Ví dụ lọc Googlebot rồi xem:
- URL nào được crawl nhiều nhất;
- URL nào không được crawl;
- status code;
- thời gian response;
- crawl frequency.
Đây mới là lúc Crawl Budget trở thành một bài toán dữ liệu thực sự.
Không phải cảm giác.
Nhưng nhớ xác minh Googlebot
User-Agent có chữ:
Googlebotkhông chứng minh request thực sự đến từ Google.
Bot giả có thể ghi bất cứ User-Agent nào.
Nếu phân tích log nghiêm túc, cần xác minh crawler theo hướng dẫn Google bằng reverse DNS hoặc IP range chính thức.
Nha để phần log analysis cho một bài riêng.
Crawl Depth có phải Crawl Budget không?
Không.
Nhưng có liên quan tới discovery.
Ví dụ một bài quan trọng cần đi:
Homepage ↓ Category ↓ Page 2 ↓ Page 3 ↓ Page 4 ↓ Page 5 ↓ Articlethì crawler phải đi khá sâu.
Internal Link tốt có thể rút ngắn:
Article mới ↓ Article cũ liên quanĐây là lý do Nha không xem Pagination là con đường duy nhất tới bài cũ.
Internal Link có làm tăng Crawl Budget không?
Không theo nghĩa:
Thêm 10 Internal Link → Google cấp thêm 100 crawl request.
Nhưng Internal Link giúp:
- Google khám phá URL;
- hiểu cấu trúc;
- nhận biết trang quan trọng;
- tạo đường đi hợp lý.
Nha đã nói kỹ trong bài Internal Link là gì?.
Quality có liên quan Crawl Demand không?
Có.
Đây là một cập nhật đáng chú ý trong tài liệu Google hiện tại.
Google nói việc phân bổ crawling cho Google Search có thể cân nhắc những yếu tố như:
- popularity;
- overall user value;
- content uniqueness;
- serving capacity.
Tức là muốn tăng crawl demand không chỉ có một câu chuyện kỹ thuật.
Content quality vẫn liên quan.
Nhưng đừng hiểu ngược thành:
Google crawl ít = nội dung dở.
Không đủ dữ liệu để kết luận vậy.
Website migration có thể làm Crawl Demand tăng
Khi website:
- đổi domain;
- đổi URL hàng loạt;
- thay cấu trúc site;
Google cần xử lý lại rất nhiều URL.
Google cho biết các site-wide events như migration có thể làm crawl demand tăng.
Đây là thời điểm server capacity và redirect architecture trở nên quan trọng hơn bình thường.
Subdomain có Crawl Budget riêng không?
Trong tài liệu crawl infrastructure hiện tại, Google định nghĩa site cho mục đích Crawl Budget theo:
hostname.
Ví dụ:
www.example.comvà:
shop.example.comđược xem là các site khác nhau trong ngữ cảnh này.
Điều này đáng nhớ với hệ thống dùng:
- CDN;
- media subdomain;
- shop;
- API;
- nhiều ứng dụng trên subdomain.
Crawl Budget không đơn giản là một ví chung cho toàn domain root.
CSS, JavaScript và ảnh có tốn Crawl Budget không?
Những resource Google cần crawl để render trang cũng tiêu tốn tài nguyên crawl.
Ví dụ:
- CSS;
- JavaScript;
- XHR;
- resource nhúng.
Nhưng đừng vì vậy chặn hết:
/css/ /js/trong robots.txt.
Nếu chúng cần để Google hiểu và render trang, chặn chúng có thể tạo vấn đề lớn hơn số request tiết kiệm được.
“Tối ưu Crawl Budget” sai cách trông thế nào?
Nha thấy vài kiểu như:
Chặn Pagination
Disallow: /*-prồi Google mất đường tới bài cũ.
Noindex hàng loạt
với mục tiêu tiết kiệm crawl.
Google vẫn phải crawl để nhìn thấy noindex.
Chặn CSS và JS
để giảm request.
Rồi Google render trang không đúng.
Xóa Internal Link
vì nghĩ ít link thì bot đi ít hơn.
Đổi lại bot khó tìm trang quan trọng.
Submit Sitemap liên tục
với hy vọng Google sẽ crawl nhiều hơn.
Google đã nói sitemap là gợi ý.
Không phải nút tăng ngân sách.
Vậy tối ưu Crawl Budget đúng là làm gì?
Nếu website thực sự có vấn đề, Nha sẽ làm theo thứ tự.
1. Xác nhận vấn đề có thật
Kiểm tra:
- Crawl Stats;
- Page Indexing;
- server log;
- URL Inspection.
2. Audit URL Inventory
Tìm:
- duplicate;
- parameter;
- filter;
- search URL;
- soft 404;
- redirect chain;
- infinite spaces.
3. Sửa URL architecture
Đừng chỉ chặn triệu chứng.
Nếu CMS tạo vô hạn URL thì nên sửa nguồn sinh URL khi có thể.
4. Giữ Sitemap sạch
Chỉ các URL cần crawl/index.
5. robots.txt đúng vai trò
Chặn vùng thật sự không cần Google crawl.
6. Giảm Soft 404
URL mất thì trả status đúng.
7. Rút ngắn Redirect Chain
Redirect trực tiếp tới URL cuối.
8. Tối ưu server
Giảm:
- latency;
- 5xx;
- 429;
- timeout.
9. Hỗ trợ HTTP caching
304 khi phù hợp.
10. Cải thiện Content Quality
Đừng dùng crawl budget để chữa một inventory đầy URL mỏng.
Cách Nha biết manhtunha.com chưa cần ám ảnh Crawl Budget
Nha sẽ tự hỏi:
- Bài mới có thường xuyên bị Google bỏ nhiều tuần chưa crawl không?
- Có hàng nghìn URL ở Discovered - currently not indexed không?
- Googlebot có làm server quá tải không?
- Crawl Stats có nhiều 5xx, timeout hay hostload issue không?
- Hệ thống có sinh vô số parameter/filter URL không?
- Search Console có cho thấy một backlog crawling đáng kể không?
Nếu phần lớn là:
Không.
Thì Nha không tối ưu Crawl Budget nâng cao.
Nha quay về:
- content;
- Internal Link;
- category;
- index quality;
- site architecture.
SEO có đủ việc thật để làm rồi.
Không cần tự phát minh thêm việc.
Checklist Crawl Budget Nha sẽ dùng
- Website có đủ lớn để vấn đề Crawl Budget đáng quan tâm không?
- Có nhiều URL Discovered - currently not indexed không?
- Server response time có ổn định không?
- Có 5xx hoặc 429 bất thường không?
- Googlebot đang crawl URL nào nhiều nhất?
- Có parameter URL vô hạn không?
- Có duplicate URL không?
- Có soft 404 không?
- Có redirect chain dài không?
- Sitemap có sạch không?
- lastmod có chính xác không?
- robots.txt có chặn đúng URL không?
- Có chặn nhầm CSS/JS quan trọng không?
- HTTP caching có hoạt động tốt không?
- Có thể trả 304 khi nội dung chưa đổi không?
- Bài quan trọng có Internal Link rõ không?
- Pagination có crawlable không?
- URL cũ bị xóa có trả 404/410 đúng không?
Những điều Nha không làm chỉ để “tối ưu Crawl Budget”
- Không chặn URL hàng loạt khi chưa biết Google đang crawl gì.
- Không noindex chỉ để tiết kiệm crawl.
- Không chặn Pagination một cách máy móc.
- Không chặn CSS/JS cần thiết.
- Không xóa Internal Link vì sợ bot crawl nhiều.
- Không submit Sitemap liên tục.
- Không xem crawl request càng cao càng tốt.
- Không xem crawl request thấp là bằng chứng Google ghét website.
- Không tối ưu Crawl Budget trước khi chứng minh website có vấn đề Crawl Budget.
Crawl Budget có quan trọng với AI Search không?
Gián tiếp.
Không có:
Crawl Budget GEOhay:
AI Crawl Budget ScoreNhưng chuỗi cơ bản vẫn còn:
Discover ↓ Crawl ↓ Index ↓ Understand ↓ Retrieve ↓ ServeNếu một URL quan trọng chưa được crawl thì nói chuyện:
- AEO;
- GEO;
- AI Overviews;
- AI Mode
vẫn còn sớm.
Technical SEO không trở nên lỗi thời vì AI.
Nó chỉ tiếp tục làm phần việc âm thầm của mình.
Bạn nên mang gì về sau bài này?
- Crawl Budget là tập URL Google có thể và muốn crawl.
- Nó được hình thành từ Crawl Capacity Limit và Crawl Demand.
- Google nói phần lớn website nhỏ không cần tối ưu Crawl Budget nâng cao.
- Hướng dẫn nâng cao chủ yếu dành cho website rất lớn, website từ khoảng 10.000 URL thay đổi hằng ngày hoặc site có lượng lớn Discovered - currently not indexed.
- Server khỏe chỉ làm tăng khả năng crawl, không bảo đảm Google muốn crawl nhiều hơn.
- URL Inventory dư thừa là thứ chủ website có thể kiểm soát rất nhiều.
- Duplicate, soft 404, infinite URL, redirect chain và server error đều có thể làm crawling kém hiệu quả.
- Sitemap và robots.txt hỗ trợ quản lý crawl nhưng phải dùng đúng vai trò.
- 304 Not Modified và HTTP caching có thể tiết kiệm tài nguyên crawling thật sự.
- Crawl nhiều hơn không tự động giúp ranking cao hơn.
Nếu phải giữ lại một câu sau bài này, Nha chọn:
Đừng tối ưu Crawl Budget trước khi chứng minh mình đang thiếu Crawl Budget.
Nghe hơi ngược với tinh thần checklist SEO.
Nhưng Nha thấy khá hợp với cách làm kỹ thuật.
Có lỗi.
Đo.
Tìm nguyên nhân.
Rồi sửa.
Không có lỗi...
thì để Googlebot làm việc của Googlebot.
Nguồn và tài liệu tham khảo
Nha ưu tiên tài liệu chính thức của Google và kiểm tra lại vào tháng 11/2026.
- Google Crawling Infrastructure - Crawl Budget Management
Nguồn chính của bài. Tài liệu được cập nhật ngày 22/07/2026, giải thích Crawl Capacity Limit, Crawl Demand, URL inventory và các trường hợp website thật sự cần quan tâm tới Crawl Budget. - Google Search Central - Troubleshoot crawling errors
Hướng dẫn kiểm tra Host availability, Crawl Stats, URL chưa được crawl, server capacity, sitemap, robots.txt và cách cải thiện crawl efficiency. - Google Search Central - How Google Search Works
Tài liệu giải thích Crawling, Indexing và Serving, đồng thời cho thấy crawl chỉ là bước đầu của quy trình Google Search. - Google Crawling Infrastructure - How HTTP status codes affect Google's crawlers
Tài liệu giải thích cách Google crawler xử lý 2xx, 3xx, 4xx, 5xx và 304 Not Modified. - Google Search Central - Link best practices
Hướng dẫn sử dụng crawlable links để Google khám phá URL và hiểu cấu trúc website. - Google Search Central - Build and submit a Sitemap
Tài liệu về Sitemap XML, canonical URL, lastmod và cách giúp Google khám phá các URL quan trọng.
Lưu ý: Crawl Budget là vấn đề có thật nhưng không phải website nào cũng cần tối ưu nâng cao. Trước khi thay đổi robots.txt, URL architecture hoặc hệ thống crawling chỉ để tiết kiệm ngân sách crawl, nên dùng Search Console và server log để xác nhận vấn đề thực sự tồn tại.
Cảm ơn bạn đã đọc hết bài viết!
Bài viết sau
Giới thiệu
- Nguyễn Văn Nha
- Mãnh Tử Nha
- 11/07
- Developer - Blogger - Marketer
- Đồng Văn Cống, Thành phố Hồ Chí Minh
- Chat ngay
- 0393 314 999
- [email protected]
- Follow me on Facebook
- Follow me on twitter
- Mãnh Tử Nha Channel
- Follow me on Linkedin
- Follow me on Zalo
- Follow me on Tiktok
- Follow me on Strava
- www.manhtunha.com
- www.NHA.one
Tìm kiếm Google
Bài viết mới nhất
 Crawl Budget là gì? Blog vài nghìn URL có thật sự cần tối ưu không?
 50+ thuật ngữ chạy bộ: Pace, Cadence, HM, FM, Sub, Trail
 Tốc độ màn trập là gì? Cách chụp đứng chuyển động và tạo vệt sáng
 Chạy bộ mỗi ngày có tốt không? Khi nào nên nghỉ?
 Dữ liệu thiếu, dữ liệu trùng: Khi nào nên sửa, khi nào không nên xóa?
Có thể bạn thích
Xem nhiều nhất
 Bài học từ ba con chuột61.117 lượt xem
 Người chiến thắng59.027 lượt xem
 Bảng xếp hạng các Pokémon theo chỉ số CP56.875 lượt xem

 Bài học về sự tự cao55.489 lượt xem
Liên kết


