 English (EN)

Dữ liệu thiếu, dữ liệu trùng: Khi nào nên sửa, khi nào không nên xóa?
Xem nhanh:
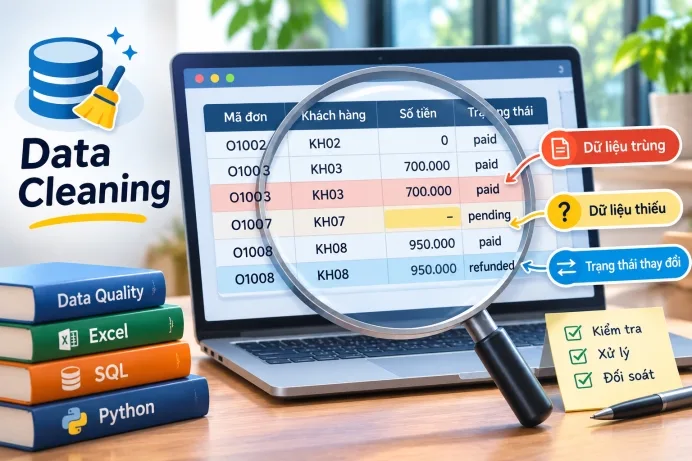
- 1. Một file có 12 dòng nhưng chỉ có 10 đơn hàng
- 2. Dữ liệu thiếu là gì? Đừng nhầm ô trống với số 0
- 3. Khi nào nên giữ dữ liệu thiếu, khi nào nên điền?
- 4. Hai dòng giống nhau có chắc là dữ liệu trùng?
- 5. Cùng một khách hàng có nhiều đơn hàng không phải là dữ liệu trùng
- 6. Chọn sai cách loại trùng, báo cáo lệch 1,65 triệu đồng
- 7. Một quy trình làm sạch dữ liệu Nha muốn áp dụng
- 8. Thực hành với Excel: Tìm dữ liệu thiếu và dữ liệu trùng
- 9. Thực hành với SQL Server: Đếm trùng trước, chưa xóa vội
- 10. Thực hành với Python pandas
- 11. Vì sao không nên tự động dùng dropna() cho cả bảng?
- 12. Làm sao để hạn chế dữ liệu trùng ngay từ đầu?
- 13. Một checklist trước khi bấm xóa dữ liệu
- 14. Dữ liệu sạch không có nghĩa là dữ liệu không còn ô trống
- Tài liệu tham khảo
Giả sử chú Nha nhận được một file Excel chứa dữ liệu đơn hàng của một cửa hàng trực tuyến.
File có 12 dòng.
Trong đó có vài số điện thoại bị bỏ trống, một đơn hàng không có giá trị tiền, và hai mã đơn hàng xuất hiện nhiều lần.
Thoạt nhìn, cách xử lý có vẻ đơn giản: xóa những dòng bị trùng, điền số 0 vào ô trống rồi xuất báo cáo.
Xong!
Nhưng nếu làm như vậy, chúng ta có thể vô tình xóa mất lịch sử hoàn tiền của khách hàng, biến một giá trị chưa biết thành số 0 hoặc làm thay đổi kết quả kinh doanh.
Đó là điều chú Nha 27 tuổi muốn cùng bạn tìm hiểu hôm nay: dữ liệu thiếu và dữ liệu trùng là gì, khi nào nên sửa, khi nào nên giữ nguyên và làm sao để kiểm tra bằng Excel, SQL Server hoặc Python.
Bài này có một bộ dữ liệu giả định để thực hành. Các kết quả được tính từ chính bộ dữ liệu ấy, không phải những con số minh họa tùy ý.
1. Một file có 12 dòng nhưng chỉ có 10 đơn hàng
Hãy bắt đầu với một bảng dữ liệu nhỏ.
Trong hệ thống bán hàng giả định, mỗi đơn hàng có mã định danh, mã khách hàng, giá trị đơn hàng, trạng thái và thời điểm cập nhật.
Để dễ quan sát, chúng ta tạm ẩn bớt những trường không cần thiết và xem bảng sau:
| Dòng | Mã đơn | Giá trị (đồng) | Trạng thái |
|---|---|---|---|
| 1 | O1001 | 500.000 | paid |
| 2 | O1002 | 0 | paid |
| 3 | O1003 | 700.000 | paid |
| 4 | O1003 | 700.000 | paid |
| 5 | O1004 | 850.000 | pending |
| 6 | O1005 | 1.200.000 | cancelled |
| 7 | O1006 | 650.000 | paid |
| 8 | O1007 | Trống | pending |
| 9 | O1008 | 950.000 | paid |
| 10 | O1008 | 950.000 | refunded |
| 11 | O1009 | 430.000 | paid |
| 12 | O1010 | 250.000 | paid |
Đây là dữ liệu hoàn toàn giả định. Tên khách hàng, số liên hệ và mã đơn hàng trong file CSV đều được tạo cho mục đích thực hành.
Trong bảng, paid là trạng thái đã thanh toán, pending là đang chờ, cancelled là đã hủy và refunded là đã hoàn tiền theo quy ước của ví dụ.
Nhìn kỹ một chút, chúng ta sẽ thấy:
- Mã O1003 xuất hiện hai lần với cùng thông tin nghiệp vụ.
- Mã O1008 xuất hiện hai lần nhưng có trạng thái khác nhau.
- Mã O1007 chưa có giá trị đơn hàng.
- Mã O1002 có giá trị bằng 0.
- Trong file đầy đủ, ba dòng không có số điện thoại.
Vậy có nên xóa tất cả những dòng trùng và điền 0 vào mọi ô trống?
Chưa nên.
Chúng ta cần biết từng trường hợp xảy ra vì sao.
2. Dữ liệu thiếu là gì? Đừng nhầm ô trống với số 0
Dữ liệu thiếu, tiếng Anh là missing data, xuất hiện khi một giá trị cần quan sát hoặc ghi nhận không có sẵn trong bộ dữ liệu.
Trong hệ thống dữ liệu, chúng ta có thể gặp những cách biểu diễn như NULL trong SQL hoặc các giá trị thiếu như NaN, NaT và NA trong pandas.
Nhưng không phải mọi ô trống đều có cùng ý nghĩa.
Ví dụ, một ô số điện thoại bị bỏ trống có thể do khách không cung cấp, hệ thống không nhận được dữ liệu hoặc trường đó không bắt buộc trong quy trình đặt hàng.
Một trường số tiền bị thiếu lại là vấn đề khác. Nó có thể phản ánh việc đơn hàng chưa được tính giá, quá trình đồng bộ bị lỗi hoặc dữ liệu chưa hoàn tất.
Không thể mặc định hai trường hợp ấy có cùng cách xử lý.
NULL không giống 0
Trong bộ dữ liệu mẫu, đơn O1002 có giá trị là 0 đồng, còn đơn O1007 không có giá trị tiền.
Hai trường hợp này khác nhau.
Giá trị 0 là một giá trị số đã được ghi nhận. Nó có thể hợp lệ, chẳng hạn một đơn được miễn phí hoàn toàn, nhưng vẫn cần đối chiếu quy tắc nghiệp vụ.
Giá trị NULL thể hiện rằng giá trị hiện chưa được ghi nhận hoặc không có sẵn.
Nếu tự động biến NULL thành 0, chúng ta đã thay đổi ý nghĩa của thông tin.
Ví dụ, một đơn hàng chưa biết giá trị không đồng nghĩa với một đơn hàng có giá bằng 0 đồng.
Đây là điều Nha muốn nhớ trước khi sử dụng bất kỳ tính năng Fill Blanks hay Fill Missing Values nào.
Ô trống cũng không luôn đồng nghĩa với NULL
Trong một hệ thống thực tế, trường văn bản có thể chứa chuỗi rỗng, một vài dấu cách hoặc những giá trị đại diện như N/A, Unknown và dấu gạch ngang.
Các giá trị này có thể cần được chuẩn hóa để phục vụ phân tích.
Nhưng phải cẩn thận.
Đôi khi N/A mang nghĩa không áp dụng, trong khi Unknown có nghĩa thông tin chưa biết. Gộp cả hai thành một trạng thái thiếu có thể làm mất thông tin nghiệp vụ.
Vì vậy, trước khi chuẩn hóa, Nha sẽ tìm hiểu quy ước dữ liệu của hệ thống.
3. Khi nào nên giữ dữ liệu thiếu, khi nào nên điền?
Không có một phương pháp xử lý dữ liệu thiếu phù hợp với mọi trường hợp.
Chúng ta nên bắt đầu từ câu hỏi: trường dữ liệu này được sử dụng để làm gì?
| Tình huống | Hướng xử lý cần cân nhắc |
|---|---|
| Khách không cung cấp số điện thoại | Giữ trạng thái thiếu hoặc bổ sung từ nguồn hợp lệ |
| Đơn hàng chưa được tính giá | Giữ NULL, kiểm tra trạng thái đơn và nguồn dữ liệu |
| Dữ liệu thiếu do đồng bộ thất bại | Đối soát và đồng bộ lại từ hệ thống gốc |
| Giá trị 0 có thể hợp lệ | Kiểm tra quy tắc nghiệp vụ, không tự chuyển thành NULL |
| Một số quan sát thiếu dữ liệu trong bài toán dự đoán | Cân nhắc phương pháp điền dữ liệu phù hợp và kiểm tra sai lệch |
Trong phân tích thống kê hoặc Machine Learning, người ta có thể sử dụng những phương pháp điền dữ liệu thiếu, gọi là imputation.
Ví dụ, điền bằng trung bình cộng, trung vị hoặc giá trị dự đoán từ mô hình.
Nhưng đây là những phương pháp cần có mục tiêu và giả định rõ ràng.
Giả sử một bảng đơn hàng có 100 giá trị, trong đó một đơn chưa biết số tiền.
Việc điền số tiền trung bình của 99 đơn còn lại có thể tạo ra một giá trị ước lượng, nhưng không biến nó thành số tiền thực tế của đơn hàng ấy.
Đặc biệt, nếu giá trị thiếu liên quan đến một quy trình nghiệp vụ cụ thể, chẳng hạn đơn chưa thanh toán thường chưa có số tiền cuối cùng, việc điền giá trị trung bình có thể tạo ra sai lệch có hệ thống.
Trong pandas, các phương thức như isna(), dropna() và fillna() cho phép phát hiện, loại bỏ hoặc điền dữ liệu thiếu.
Tuy nhiên, việc thư viện cung cấp một phương thức không có nghĩa phương thức ấy luôn phù hợp với mọi bộ dữ liệu.
Nguồn: pandas – Working with missing data.
4. Hai dòng giống nhau có chắc là dữ liệu trùng?
Chúng ta quay lại mã đơn O1003.
Trong bộ CSV, dòng số 3 và dòng số 4 có cùng mã đơn, mã khách hàng, ngày đặt, số tiền, trạng thái và thời điểm cập nhật.
Chỉ có row_id, mã thứ tự của bản ghi trong file, là khác nhau.
Theo giả định của bài thực hành, đây là một bản ghi nghiệp vụ được nạp lặp lại.
Vì vậy, khi tạo bảng đơn hàng hiện tại, chúng ta chỉ muốn giữ một bản ghi đại diện cho O1003.
Nhưng hãy xem trường hợp của O1008.
| Mã đơn | Trạng thái | Thời điểm cập nhật |
|---|---|---|
| O1008 | paid | 04/11/2026 11:00 |
| O1008 | refunded | 05/11/2026 09:00 |
Đây không phải hai đơn hàng khác nhau.
Nhưng cũng không phải hai bản ghi giống hệt nhau.
Trong mô hình dữ liệu của ví dụ, chúng là hai phiên bản trạng thái của cùng một đơn hàng.
Nếu muốn biết trạng thái hiện tại của O1008, chúng ta chọn phiên bản có thời điểm cập nhật mới hơn: refunded.
Nếu muốn phân tích lịch sử thay đổi trạng thái, cả hai phiên bản đều có giá trị.
Xóa một phiên bản khỏi dữ liệu lịch sử có thể khiến chúng ta không còn biết đơn hàng đã từng ở trạng thái paid trước khi được hoàn tiền.
Vì vậy, cần phân biệt hai nhiệm vụ:
- Tạo bảng trạng thái hiện tại, chỉ có một dòng cho mỗi đơn hàng.
- Lưu lịch sử cập nhật để kiểm tra hành trình thay đổi của đơn hàng.
Hai nhiệm vụ này không nhất thiết sử dụng cùng một bảng dữ liệu.
Và nếu bảng dữ liệu nguồn thực chất là danh sách các sự kiện nghiệp vụ, không phải các phiên bản trạng thái đầy đủ, chúng ta còn cần quy tắc dựng lại trạng thái hiện tại từ chuỗi sự kiện.
5. Cùng một khách hàng có nhiều đơn hàng không phải là dữ liệu trùng
Trong bộ dữ liệu, khách hàng C01 xuất hiện ở hai mã đơn:
- O1001, trị giá 500.000 đồng.
- O1006, trị giá 650.000 đồng.
Đây là hai giao dịch khác nhau của cùng một khách hàng.
Nếu sử dụng mã khách hàng để loại bỏ bản ghi trùng trong bảng đơn hàng, chúng ta có thể làm mất một giao dịch hợp lệ.
Điểm này nghe đơn giản, nhưng liên quan đến một khái niệm rất quan trọng trong phân tích dữ liệu: grain, hay mức chi tiết của mỗi dòng dữ liệu.
Trong bảng đơn hàng hiện tại của ví dụ, mỗi dòng đại diện cho một đơn hàng.
Trong bảng khách hàng, mỗi dòng có thể đại diện cho một khách hàng.
Trong bảng chi tiết sản phẩm, mỗi dòng có thể đại diện cho một mặt hàng thuộc một đơn hàng.
Một mã đơn hàng xuất hiện nhiều lần trong bảng chi tiết sản phẩm có thể hoàn toàn bình thường.
Nhưng trong bảng được thiết kế để chỉ lưu một trạng thái hiện tại cho mỗi đơn hàng, việc cùng mã đơn xuất hiện nhiều lần là dấu hiệu cần kiểm tra.
Nói cách khác, trước khi tìm dữ liệu trùng, chúng ta phải biết thế nào là một bản ghi duy nhất trong bảng đang phân tích.
6. Chọn sai cách loại trùng, báo cáo lệch 1,65 triệu đồng
Bây giờ chúng ta thử tính tổng giá trị các dòng có trạng thái paid trong file gốc.
Nếu chỉ lọc status = paid rồi cộng amount_vnd của mọi dòng, kết quả là:
4.180.000 đồng.
Nhưng con số ấy có hai vấn đề.
Thứ nhất, O1003 được cộng hai lần do bản ghi bị nạp lặp.
Thứ hai, phiên bản paid cũ của O1008 vẫn được cộng, trong khi bản cập nhật mới nhất của đơn này là refunded.
Với mục tiêu tạo báo cáo trạng thái hiện tại, chúng ta cần xác định một phiên bản mới nhất cho mỗi mã đơn.
Sau khi thực hiện theo quy tắc ấy, bộ dữ liệu còn 10 đơn hàng duy nhất.
Tổng giá trị của các đơn có trạng thái hiện tại là paid bằng:
2.530.000 đồng.
So sánh kết quả:
| Cách tính | Giá trị |
|---|---|
| Cộng tất cả dòng paid trong dữ liệu gốc | 4.180.000 đồng |
| Cộng các đơn đang có trạng thái paid trong bảng hiện tại | 2.530.000 đồng |
| Chênh lệch | 1.650.000 đồng |
Chênh lệch này đến từ hai khoản:
- 700.000 đồng do O1003 bị tính hai lần.
- 950.000 đồng do phiên bản paid cũ của O1008 vẫn được tính.
Tổng cộng: 1.650.000 đồng.
Đây là hai kết quả được tính từ bộ dữ liệu thực hành.
Nhưng cần lưu ý: 2.530.000 đồng là tổng giá trị của các đơn có trạng thái hiện tại là paid theo quy ước của ví dụ, không phải một chỉ tiêu doanh thu kế toán đã được xác nhận.
Để tính doanh thu tài chính hoặc dòng tiền thực thu, doanh nghiệp cần định nghĩa thêm thời điểm ghi nhận, hoàn tiền, chiết khấu, thuế, phí và những quy tắc liên quan.
Điều này quan trọng vì một phép cộng đúng trên bảng trạng thái đơn hàng chưa chắc đã trả lời đúng câu hỏi về doanh thu kế toán.
7. Một quy trình làm sạch dữ liệu Nha muốn áp dụng
Sau khi xem những trường hợp trên, Nha thử sắp xếp công việc làm sạch dữ liệu thành sáu bước.
Bước 1: Xác định mục tiêu phân tích
Chúng ta đang muốn tính số đơn hàng, doanh thu, số khách hàng hay phân tích lịch sử cập nhật?
Mỗi mục tiêu có thể yêu cầu một tập dữ liệu và một mức chi tiết khác nhau.
Không nên xóa bản ghi trước khi trả lời câu hỏi này.
Bước 2: Giữ lại dữ liệu nguồn
Tạo bản sao để xử lý hoặc sử dụng một bảng trung gian riêng.
Với dữ liệu vận hành quan trọng, cần bảo đảm khả năng truy xuất về nguồn và khôi phục khi có lỗi.
Nha không muốn một lần bấm Remove Duplicates làm mất những thông tin cần dùng để đối soát về sau.
Bước 3: Kiểm tra chất lượng dữ liệu
Các câu hỏi cần kiểm tra gồm:
- Những cột nào có giá trị thiếu?
- Có bao nhiêu mã định danh xuất hiện nhiều lần?
- Kiểu dữ liệu và định dạng có thống nhất không?
- Có giá trị nào nằm ngoài phạm vi nghiệp vụ hợp lệ không?
- Có dữ liệu được đồng bộ muộn hoặc thiếu phiên bản không?
Bước 4: Phân loại vấn đề
Không nên gom mọi vấn đề vào một nhóm "dữ liệu bẩn".
Hãy phân biệt dữ liệu trùng do lỗi nạp, nhiều phiên bản hợp lệ, dữ liệu thiếu chưa xác định nguyên nhân và giá trị bất thường nhưng có thể hợp lệ.
Bước 5: Xử lý theo quy tắc có thể giải thích
Ví dụ, với bảng trạng thái đơn hàng hiện tại, quy tắc của chúng ta là:
Mỗi order_id chỉ có một bản ghi; chọn bản ghi có updated_at mới nhất. Nếu hai bản ghi có cùng thời điểm cập nhật, sử dụng row_id như tiêu chí phụ trong bộ dữ liệu thực hành.
Trong hệ thống thật, quy tắc phân xử khi trùng thời điểm phải dựa trên thông tin đáng tin cậy hơn, chẳng hạn phiên bản sự kiện, trình tự ghi nhận hoặc quy tắc ưu tiên nguồn.
Bước 6: Đối soát trước và sau xử lý
Ghi lại số dòng đầu vào, số dòng đầu ra, số bản ghi bị loại khỏi bảng kết quả và mức thay đổi của các chỉ số quan trọng.
Đây là bước rất dễ bị bỏ qua.
Nếu không đối soát, chúng ta có thể tạo ra một file nhìn gọn gàng hơn nhưng sai về mặt nghiệp vụ.
8. Thực hành với Excel: Tìm dữ liệu thiếu và dữ liệu trùng
Bạn có thể tải file CSV thực hành được cung cấp kèm bài viết hoặc tự tạo bảng với những giá trị ở phần đầu.
Trong file đầy đủ, các cột được sắp xếp theo thứ tự:
row_id order_id customer_id customer_name phone order_date amount_vnd status updated_atGiả sử dữ liệu bắt đầu ở hàng 2 và kết thúc tại hàng 13.
Kiểm tra số điện thoại bị thiếu
Cột E chứa phone.
Để đếm số ô trống, sử dụng:
=COUNTBLANK(E2:E13)Kết quả là 3.
Nhớ rằng nếu hệ thống lưu một vài dấu cách thay vì ô trống thực sự, chúng ta cần kiểm tra và chuẩn hóa riêng.
Kiểm tra giá trị đơn hàng bị thiếu
Cột G chứa amount_vnd.
Sử dụng:
=COUNTBLANK(G2:G13)Kết quả là 1.
Đơn có giá trị bằng 0 không bị tính vào nhóm ô trống.
Phát hiện mã đơn hàng xuất hiện nhiều lần
Cột B chứa order_id.
Tại ô J2, nhập công thức:
=COUNTIF($B$2:$B$13,B2)Kéo công thức xuống đến hàng 13.
Những mã có kết quả lớn hơn 1 cần được kiểm tra.
Trong bộ dữ liệu, O1003 và O1008 đều xuất hiện hai lần.
Nhưng như chúng ta đã biết, hai mã này có nguyên nhân xuất hiện nhiều lần khác nhau.
Dùng Conditional Formatting
Chọn vùng B2:B13, vào Home, chọn Conditional Formatting, chọn Highlight Cells Rules rồi chọn Duplicate Values.
Excel sẽ làm nổi bật những mã đơn xuất hiện nhiều lần.
Đây mới là bước phát hiện.
Đừng xóa ngay.
Nếu sử dụng Data > Remove Duplicates, cần nhớ rằng Excel loại bỏ các dòng dựa trên những cột được chọn và giữ lần xuất hiện đầu tiên.
Với bài toán trạng thái hiện tại, chúng ta phải xác định trước bản ghi nào cần giữ. Chẳng hạn, trong file mẫu, có thể sắp xếp theo updated_at giảm dần và row_id giảm dần rồi mới tạo bản kết quả theo order_id.
Cách này chỉ phù hợp với quy tắc của bài thực hành. Với dữ liệu sản xuất, hãy kiểm tra khả năng có bản ghi cập nhật cùng thời điểm và những quy tắc ưu tiên khác.
Microsoft cũng khuyến nghị sao chép dữ liệu trước khi sử dụng Remove Duplicates vì chức năng này xóa các dòng trùng khỏi vùng dữ liệu được chọn.
Nguồn: Microsoft Support – Find and remove duplicates.
9. Thực hành với SQL Server: Đếm trùng trước, chưa xóa vội
Nếu làm việc với cơ sở dữ liệu, SQL giúp chúng ta kiểm tra các vấn đề này khá thuận tiện.
Bộ mã SQL kèm bài viết có tạo sẵn bảng tạm #Orders với 12 dòng dữ liệu, vì vậy bạn có thể chạy trong SQL Server mà không cần sửa bảng nghiệp vụ.
Kiểm tra các mã đơn xuất hiện nhiều lần
SELECT

order_id,

COUNT(*) AS so_dong FROM #Orders GROUP BY order_id HAVING COUNT(*) > 1;
Kết quả:
| order_id | so_dong |
|---|---|
| O1003 | 2 |
| O1008 | 2 |
Truy vấn này phát hiện những mã xuất hiện nhiều lần.
Nó chưa cho biết những dòng ấy có phải dữ liệu lỗi hay không.
Kiểm tra dữ liệu thiếu
SELECT

COUNT(*) AS tong_so_dong,

SUM(

CASE

WHEN phone IS NULL

OR LTRIM(RTRIM(phone)) = ''

THEN 1 ELSE 0

END

) AS so_dong_thieu_phone,

SUM(

CASE

WHEN amount_vnd IS NULL

THEN 1 ELSE 0

END

) AS so_dong_thieu_gia_tri FROM #Orders;
Kết quả lần lượt là 12 dòng nguồn, 3 dòng thiếu số điện thoại và 1 dòng thiếu giá trị tiền.
Ở đây, chúng ta kiểm tra cả NULL và chuỗi rỗng đối với trường phone.
Không nên chỉ dùng COUNT(phone) rồi mặc định kết quả là số bản ghi đủ số điện thoại, vì còn phải xét dữ liệu đang sử dụng quy ước nào cho giá trị thiếu.
Tạo bảng trạng thái hiện tại bằng ROW_NUMBER
Chúng ta sử dụng ROW_NUMBER để đánh số các phiên bản của từng mã đơn, ưu tiên thời điểm cập nhật mới nhất.
WITH Ranked AS (

SELECT

*,

ROW_NUMBER() OVER (

PARTITION BY order_id

ORDER BY updated_at DESC, row_id DESC

) AS rn

FROM #Orders ) SELECT

order_id,

customer_id,

amount_vnd,

status,

updated_at FROM Ranked WHERE rn = 1 ORDER BY order_id;
Kết quả có 10 dòng, mỗi dòng đại diện cho trạng thái hiện tại của một mã đơn.
Mã O1008 sẽ có trạng thái refunded.
Quan trọng hơn, truy vấn này không xóa dữ liệu trong bảng nguồn.
Nó chỉ tạo một kết quả phục vụ mục tiêu phân tích hiện tại.
Trong dữ liệu thật, updated_at phải thể hiện đúng thứ tự phiên bản. Nếu thời gian cập nhật bị trùng hoặc có sự kiện đến muộn, cần một quy tắc xác định thứ tự đáng tin cậy.
Microsoft có tài liệu giải thích ROW_NUMBER và việc sử dụng PARTITION BY, ORDER BY trong SQL Server.
Nguồn: Microsoft Learn – ROW_NUMBER (Transact-SQL).
10. Thực hành với Python pandas
Nếu muốn xử lý file CSV bằng Python, chúng ta có thể dùng pandas.
Cài đặt nếu môi trường của bạn chưa có:
pip install pandasĐặt file don_hang_du_lieu_loi_mau.csv trong cùng thư mục với mã Python.
Bước 1: Đọc file và kiểm tra dữ liệu thiếu
import pandas as pd

df = pd.read_csv(

"don_hang_du_lieu_loi_mau.csv",

encoding="utf-8-sig",

dtype={

"order_id": "string",

"customer_id": "string",

"phone": "string"

} )

df["amount_vnd"] = pd.to_numeric(

df["amount_vnd"],

errors="coerce" )

df["updated_at"] = pd.to_datetime(

df["updated_at"],

errors="coerce" )

print("So dong:", len(df))

print(df.isna().sum())
Việc chỉ định phone là chuỗi rất quan trọng vì số điện thoại là mã liên hệ, không phải đại lượng dùng để tính toán. Chúng ta không muốn công cụ đọc dữ liệu làm mất thông tin định dạng như số 0 ở đầu.
Trong file mẫu, những số liên hệ không trống cũng là chuỗi giả lập đã được che bớt ký tự, không phải số điện thoại thật.
Kết quả sẽ cho thấy ba giá trị thiếu ở phone và một giá trị thiếu ở amount_vnd.
Bước 2: Phát hiện mã đơn hàng lặp lại
duplicates = df[

df.duplicated(

subset=["order_id"],

keep=False

) ]

print(

duplicates[

["order_id", "status", "updated_at"]

] )
Kết quả gồm bốn dòng liên quan đến hai mã O1003 và O1008.
Tuy nhiên, duplicated() ở đây chỉ cho biết các dòng có cùng order_id, không tự xác định chúng có phải lỗi nghiệp vụ hay không.
Bước 3: Tạo bảng trạng thái hiện tại
if df["order_id"].isna().any():

raise ValueError("Thieu order_id")

if df["updated_at"].isna().any():

raise ValueError("Thieu updated_at")

latest = (

df.sort_values(

["updated_at", "row_id"],

kind="stable"

)

.drop_duplicates(

subset=["order_id"],

keep="last"

) )

print("So don hang:", len(latest))
Kết quả là 10.
Trong ví dụ, chúng ta sắp xếp bản ghi theo thời điểm cập nhật và row_id, rồi chọn phiên bản cuối cùng của mỗi order_id.
Đây là cách tạo ảnh chụp trạng thái hiện tại (current snapshot), không phải thao tác xóa lịch sử đơn hàng.
Bước 4: Đối soát giá trị các đơn có trạng thái paid
raw_paid = df.loc[

df["status"] == "paid",

"amount_vnd" ].sum()

current_paid = latest.loc[

latest["status"] == "paid",

"amount_vnd" ].sum()

print("Raw:", int(raw_paid)) print("Current:", int(current_paid)) print(

"Difference:",

int(raw_paid
- current_paid) )
Kết quả:
Raw: 4180000 Current: 2530000 Difference: 1650000Con số chênh lệch 1.650.000 đồng cho chúng ta biết rằng việc cộng các bản ghi theo trạng thái paid mà không hiểu cấu trúc dữ liệu đã tạo ra một kết quả không phù hợp với mục tiêu báo cáo trạng thái hiện tại.
Nhưng Nha muốn nhấn mạnh: đừng vội dùng drop_duplicates cho mọi bảng có mã lặp.
Trước tiên phải hiểu mỗi dòng đại diện cho điều gì và có cần giữ lại các phiên bản lịch sử hay không.
Nguồn: pandas – Indexing and selecting data, phần Duplicate data.
11. Vì sao không nên tự động dùng dropna() cho cả bảng?
Trong pandas, chúng ta có thể viết:
clean = df.dropna()Dòng lệnh rất ngắn.
Nhưng với mặc định này, pandas loại bỏ những dòng có ít nhất một giá trị thiếu.
Trong bộ dữ liệu của chúng ta, có những đơn hàng thiếu số điện thoại nhưng vẫn có đầy đủ mã đơn, giá trị và trạng thái thanh toán.
Nếu xóa toàn bộ những dòng ấy, chúng ta có thể làm mất giao dịch hợp lệ chỉ vì một trường liên hệ chưa được cung cấp.
Tương tự, điền số 0 vào mọi giá trị thiếu bằng một lệnh fillna(0) có thể khiến các trường vốn chưa biết bị hiểu thành những giá trị bằng 0 đã được ghi nhận.
Cách làm phù hợp hơn là xử lý theo từng trường, từng mục tiêu.
Ví dụ, nếu phân tích giá trị đơn hàng đã thanh toán, có thể giữ các đơn thiếu số điện thoại. Nhưng chúng ta vẫn cần kiểm tra những đơn thiếu số tiền hoặc trạng thái thanh toán không hợp lệ theo quy tắc nghiệp vụ.
Không phải cứ làm sạch dữ liệu là phải làm cho mọi ô đều có giá trị.
Một số ô để trống mới là cách thể hiện trung thực nhất về những điều hệ thống chưa biết.
12. Làm sao để hạn chế dữ liệu trùng ngay từ đầu?
Làm sạch dữ liệu sau khi phát hiện lỗi là cần thiết.
Nhưng sẽ tốt hơn nếu hệ thống giảm được khả năng phát sinh lỗi từ đầu.
Trong cơ sở dữ liệu quan hệ, chúng ta có thể sử dụng khóa chính (Primary Key), ràng buộc duy nhất (UNIQUE Constraint) hoặc unique index để bảo vệ tính duy nhất của những trường thực sự cần duy nhất.
Ví dụ, nếu bảng OrderCurrent chỉ được phép có một bản ghi cho mỗi mã đơn hàng, order_id có thể được thiết kế với một ràng buộc duy nhất.
Nhưng nếu đó là bảng OrderHistory chứa nhiều phiên bản của cùng một đơn, việc đặt UNIQUE trên order_id sẽ không phù hợp.
Thay vào đó, có thể cần một khóa riêng cho từng phiên bản hoặc sự kiện.
Đây là lý do cấu trúc cơ sở dữ liệu phải xuất phát từ ý nghĩa nghiệp vụ.
Microsoft giải thích rằng UNIQUE Constraint và unique index giúp ngăn dữ liệu trùng khóa khi thực hiện thao tác ghi vào SQL Server.
Nguồn: Microsoft Learn – Unique constraints and check constraints.
Ngoài ràng buộc dữ liệu, hệ thống thực tế còn nên cân nhắc cơ chế ghi nhận giao dịch an toàn khi thử lại, mã định danh sự kiện, giám sát quá trình đồng bộ và cảnh báo bất thường.
Những biện pháp này không loại bỏ hoàn toàn mọi vấn đề dữ liệu, nhưng giúp chúng ta phát hiện và xử lý lỗi có kiểm soát hơn.
13. Một checklist trước khi bấm xóa dữ liệu
Sau bài thực hành, Nha thử ghi lại vài câu hỏi để lần sau có thể dùng trong công việc.
- Dòng dữ liệu này đại diện cho điều gì? Khách hàng, đơn hàng, sản phẩm hay phiên bản cập nhật?
- Dựa vào trường nào để xác định trùng? Mã đơn, mã giao dịch hay một tổ hợp trường nghiệp vụ?
- Dữ liệu thiếu là chưa biết hay không áp dụng? Không nên gộp các ý nghĩa khác nhau nếu chúng ảnh hưởng đến phân tích.
- Có nguồn đáng tin để bổ sung không? Ưu tiên đối soát thay vì tự tạo giá trị.
- Nếu loại một dòng thì có mất thông tin lịch sử không? Đặc biệt chú ý dữ liệu có nhiều phiên bản.
- Kết quả tổng hợp thay đổi bao nhiêu? Ghi lại chỉ số trước và sau xử lý.
- Có thể truy xuất và khôi phục dữ liệu ban đầu không? Đừng đánh đổi khả năng kiểm tra để lấy một bảng dữ liệu trông gọn gàng.
Những câu hỏi ấy không thay thế một quy trình quản trị chất lượng dữ liệu đầy đủ.
Nhưng chúng giúp chúng ta nhận biết những tình huống cần kiểm tra thêm trước khi thực hiện thao tác không thể đảo ngược.
14. Dữ liệu sạch không có nghĩa là dữ liệu không còn ô trống
Trước đây, khi nhìn một bảng Excel có những ô bị bỏ trống hoặc dòng bị lặp, phản ứng tự nhiên của nhiều người có lẽ là muốn dọn dẹp cho gọn.
Nha cũng hiểu cảm giác ấy.
Một bảng dữ liệu đầy đủ, ngay hàng thẳng lối, nhìn dễ chịu hơn một bảng lộn xộn.
Nhưng qua bài thực hành nhỏ hôm nay, chúng ta thấy một điều thú vị.
Hai dòng có cùng mã đơn hàng chưa chắc đều là lỗi.
Một ô thiếu giá trị không nhất thiết phải điền số 0.
Một đơn hàng có trạng thái hoàn tiền không nên bị bỏ qua chỉ vì trước đó từng được ghi nhận là đã thanh toán.
Và một khách hàng mua hai lần không phải là một khách hàng cần bị loại trùng khỏi bảng đơn hàng.
Trong bài 7 lỗi trực quan hóa dữ liệu khiến biểu đồ gây hiểu nhầm, Nha đã chia sẻ chuyện cùng một bộ dữ liệu có thể tạo ra những biểu đồ khiến người xem có cảm nhận rất khác nhau.
Ở bài này, chúng ta đi thêm một bước: ngay cả trước khi dữ liệu được đưa lên biểu đồ, cách xử lý dữ liệu gốc đã có thể làm thay đổi kết quả.
Vì vậy, trước khi hỏi biểu đồ đã đẹp chưa, có lẽ nên hỏi dữ liệu dùng để vẽ đã được kiểm tra đến đâu.
Nha nghĩ một bộ dữ liệu tốt không nhất thiết phải hoàn hảo.
Điều quan trọng là chúng ta biết những gì đang có, những gì còn thiếu, những gì đã được sửa và giới hạn của kết quả phân tích.
Có lúc, quyết định hợp lý nhất là sửa dữ liệu.
Có lúc, nên giữ nguyên và ghi chú.
Và cũng có những lúc, tốt nhất là chưa làm gì cho đến khi tìm được bằng chứng đáng tin cậy.
Chậm một chút.
Nhưng báo cáo sẽ đáng tin hơn.
Tài liệu tham khảo
Toàn bộ ví dụ đơn hàng và số liệu trong bài là dữ liệu giả định. Các phương pháp xử lý được đối chiếu với tài liệu kỹ thuật chính thức sau:
- pandas – Working with missing data. Giải thích giá trị thiếu và các phương pháp isna, dropna, fillna.
- pandas – Indexing and selecting data. Tham khảo duplicated và drop_duplicates.
- Microsoft Support – Find and remove duplicates. Hướng dẫn phát hiện và loại bỏ giá trị trùng trong Excel.
- Microsoft Learn – ROW_NUMBER (Transact-SQL). Cách đánh số thứ tự bản ghi theo nhóm và quy tắc sắp xếp.
- Microsoft Learn – Remove duplicate rows from a SQL Server table. Các phương pháp kiểm tra và xử lý dữ liệu trùng.
- Microsoft Learn – Unique constraints and check constraints. Cơ chế bảo đảm tính duy nhất trong SQL Server.
- Microsoft Learn – Aggregate Functions. Quy tắc xử lý NULL của các hàm tổng hợp SQL Server.
Cảm ơn bạn đã đọc hết bài viết!
Bài viết sau
Giới thiệu
- Nguyễn Văn Nha
- Mãnh Tử Nha
- 11/07
- Developer - Blogger - Marketer
- Đồng Văn Cống, Thành phố Hồ Chí Minh
- Chat ngay
- 0393 314 999
- [email protected]
- Follow me on Facebook
- Follow me on twitter
- Mãnh Tử Nha Channel
- Follow me on Linkedin
- Follow me on Zalo
- Follow me on Tiktok
- Follow me on Strava
- www.manhtunha.com
- www.NHA.one
Tìm kiếm Google
Bài viết mới nhất
 Dữ liệu thiếu, dữ liệu trùng: Khi nào nên sửa, khi nào không nên xóa?
 AI viết Unit Test: Vì sao 100% test PASS vẫn có thể sai?
 robots.txt là gì? Chặn Google crawl không có nghĩa là chặn Google index
 Sitemap XML là gì? Có Sitemap rồi tại sao Google vẫn không Index?
 Chạy bộ buổi sáng hay buổi chiều, lúc nào tốt hơn?
Có thể bạn thích
Xem nhiều nhất
 Bài học từ ba con chuột61.107 lượt xem
 Người chiến thắng59.018 lượt xem
 Bảng xếp hạng các Pokémon theo chỉ số CP56.863 lượt xem

 Bài học về sự tự cao55.480 lượt xem
Liên kết


